องค์กรที่อยากใช้ AI กับสัญญา เอกสารภายใน หรือข้อมูลลูกค้า มักติดคำถามว่าข้อมูลจะถูกส่งไปที่ไหน Private AI ตอบโจทย์นี้ด้วยการรันโมเดลบนเซิร์ฟเวอร์ขององค์กรเอง
บทความนี้สรุปเครื่องมือ ข้อแลกเปลี่ยน ฮาร์ดแวร์ และขั้นตอนเริ่มต้นบน GPU Server ในไทย
สรุปสั้นสำหรับผู้บริหาร
ข้อมูลอยู่ในองค์กร: คำถาม เอกสาร และคำตอบประมวลผลบนเซิร์ฟเวอร์ที่องค์กรควบคุม
เครื่องมือหลัก: Ollama สำหรับเริ่มต้น vLLM สำหรับผู้ใช้จำนวนมาก และ Open WebUI เป็นหน้าแชท
สิ่งที่ต้องแลก: โมเดลอาจไม่เก่งเท่ารุ่นเรือธงที่ใช้ผ่าน API (บริการโมเดลทางเครือข่าย) มีค่า GPU และต้องมีทีมดูแล
ฮาร์ดแวร์: หน่วยความจำ GPU กำหนดขนาดโมเดล และเครื่องมือแต่ละตัวรองรับ GPU ต่างรุ่นกัน
ทางสายกลาง: แบบ Hybrid (ผสมสองแบบ) ใช้ Private AI กับข้อมูลอ่อนไหว และใช้ API กับงานทั่วไป
Private AI คืออะไร?
Private AI คือการรันโมเดล AI แบบ Open-weight (ดาวน์โหลดไปรันเองได้) บนเซิร์ฟเวอร์ที่องค์กรควบคุม เช่น GPU Server หรือ Private Cloud ทำให้คำถาม เอกสาร และคำตอบอยู่ในระบบขององค์กร ไม่ต้องส่งไปยังผู้ให้บริการภายนอก
Private AI เป็นรูปแบบการวางระบบ ไม่ใช่ชื่อผลิตภัณฑ์ ถ้ายังไม่คุ้นกับโมเดลภาษา อ่านพื้นฐานได้ที่ LLM คืออะไร
ทำไมองค์กรเลือก Private AI?
อธิปไตยข้อมูล (Data Sovereignty): รู้ว่าข้อมูลอยู่ที่ไหนและใครเข้าถึงได้ เหมาะกับสัญญา ข้อมูลการเงิน และความลับทางการค้า
ต้นทุนคาดการณ์ได้: ค่าเซิร์ฟเวอร์รายเดือนคงที่ ไม่ผันตามจำนวน token (หน่วยนับข้อความ) ยิ่งใช้มาก ต้นทุนต่อคำถามยิ่งต่ำ
ปรับแต่งได้: เลือกโมเดลเอง ฝึกเพิ่มเฉพาะทาง (Fine-tuning) และกำหนดเองว่าจะเปลี่ยนรุ่นเมื่อใด
PDPA และการส่งข้อมูลไปต่างประเทศ
พ.ร.บ.คุ้มครองข้อมูลส่วนบุคคล พ.ศ. 2562 (PDPA) มีหลักเกณฑ์เฉพาะเรื่องการส่งหรือโอนข้อมูลส่วนบุคคลไปต่างประเทศ โดยคณะกรรมการคุ้มครองข้อมูลส่วนบุคคลออกประกาศหลักเกณฑ์ตามมาตรา 29 เมื่อปี 2566
การรันโมเดลในไทยทำให้ข้อมูลที่ส่งให้ AI ไม่ต้องออกนอกประเทศ แต่หน้าที่อื่นตาม PDPA ยังอยู่ ควรปรึกษาผู้เชี่ยวชาญด้านกฎหมายก่อนตัดสินใจ
Private AI ใช้เครื่องมืออะไรบ้าง?
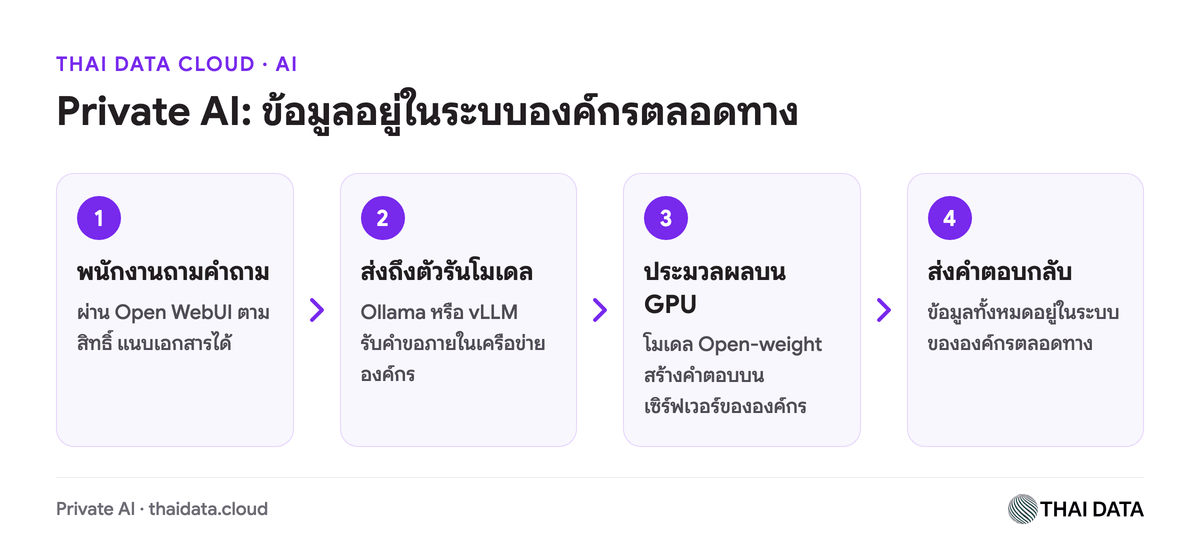
ระบบมีสามชั้น คือหน้าแชท ตัวรันโมเดล และโมเดลบน GPU ภายในเครือข่ายองค์กร
Ollama: เริ่มต้นได้เร็ว
Ollama ใช้ดาวน์โหลดและรันโมเดล LLM บนเซิร์ฟเวอร์ของตัวเอง เหมาะกับงานนำร่องและทีมเล็กที่อยากเห็นผลเร็ว
vLLM: รองรับผู้ใช้จำนวนมาก
vLLM ออกแบบมาเพื่อเสิร์ฟโมเดลให้เร็วและรับผู้ใช้พร้อมกันได้มาก มี Docker Image (แพ็กเกจซอฟต์แวร์สำเร็จรูป) ทางการที่รัน OpenAI-compatible server (API รูปแบบเดียวกับ OpenAI) แอปที่ใช้ API แบบนี้อยู่แล้วจึงย้ายมาใช้โมเดลภายในได้ง่าย
Open WebUI: หน้าแชทสำหรับพนักงาน
Open WebUI เป็นหน้าเว็บสำหรับแชท คุยกับ Ollama, OpenAI, Anthropic หรือผู้ให้บริการที่ใช้ API แบบ OpenAI-compatible ได้จากหน้าจอเดียว และสร้างคลังความรู้จากไฟล์ที่อัปโหลดเพื่อถามตอบแบบ RAG
ผู้ดูแลกำหนดบทบาท กลุ่มผู้ใช้ และสิทธิ์รายโมเดลได้ รวมถึงเชื่อมระบบล็อกอินกลางขององค์กรผ่าน SSO หรือ LDAP
Private AI ต่างจากโมเดลผ่าน API อย่างไร?
คุณภาพ: รุ่นเรือธงอย่าง Claude, GPT และ Gemini ใช้ได้ผ่าน API ส่วนโมเดลที่รันเองถูกจำกัดด้วยหน่วยความจำ GPU จึงมักเล็กกว่า
ต้นทุน: API จ่ายตาม token ส่วน Private AI เป็นค่า GPU รายเดือน คุ้มเมื่อใช้สูงและสม่ำเสมอ
การดูแล: API มีผู้ให้บริการดูแล ส่วน Private AI ต้องอัปเดต เฝ้าระวัง และสำรองข้อมูลเอง
การขยาย: API รับงานที่ขึ้นลงได้ง่าย ส่วน Private AI ต้องวางแผน GPU ตามผู้ใช้พร้อมกัน
Private AI ต้องใช้ฮาร์ดแวร์แบบไหน?
ตัวแปรหลักคือหน่วยความจำ GPU (VRAM) เพราะโมเดลต้องโหลดไว้บน GPU และต้องเหลือพื้นที่ให้ข้อความของผู้ใช้ โมเดลใหญ่ ข้อความยาว หรือผู้ใช้พร้อมกันมาก ก็ต้องใช้หน่วยความจำมาก
Quantization (ลดความละเอียดของตัวเลขในโมเดล) ช่วยประหยัดหน่วยความจำ แลกกับคุณภาพที่อาจลดลงบ้าง ส่วนรุ่น GPU ที่เครื่องมือรองรับวัดด้วย Compute Capability (ระดับสถาปัตยกรรม GPU ของ NVIDIA)
Ollama: เอกสารของ Ollama ระบุว่ารองรับตั้งแต่ Compute Capability 5.0 กับไดรเวอร์ 550 ขึ้นไป ตารางรองรับมีทั้ง T4 และ V100
vLLM: เอกสารติดตั้งของ vLLM ณ ปี 2569 ระบุว่าต้องใช้ Linux และ Compute Capability 7.5 ขึ้นไป เช่น T4 ขณะที่ V100 อยู่ที่ 7.0 ตามตารางของ Ollama จึงควรใช้ T4 กับ vLLM
ใช้ Private AI คู่กับโมเดลผ่าน API แบบ Hybrid อย่างไร?
ไม่จำเป็นต้องเลือกทางเดียว แนวทาง Hybrid แบ่งงานตามความอ่อนไหวของข้อมูล
แบ่งชั้นข้อมูล: ข้อมูลส่วนบุคคล สัญญา และการเงินใช้ Private AI งานทั่วไปใช้ API ได้ ดูแนวทางวางกติกาใน AI Governance
หน้าจอเดียว สิทธิ์ต่างกัน: Open WebUI เชื่อมทั้งโมเดลภายในและภายนอก และกำหนดได้ว่ากลุ่มใดใช้โมเดลใด
API รูปแบบเดียวกัน: vLLM ที่เปิด API แบบ OpenAI-compatible ทำให้แอปสลับไปใช้บริการภายนอกที่ใช้รูปแบบเดียวกันได้ด้วยการแก้ค่าตั้ง
ขั้นตอนเริ่มต้น Private AI บน GPU Server ของ THAI DATA CLOUD
ขั้นตอนที่ 1: เลือกงานนำร่องและกำหนดชั้นข้อมูล
เลือกงานที่วัดผลได้และใช้ข้อมูลที่ไม่ควรออกนอกองค์กร เช่น ถามตอบจากคู่มือภายใน และกำหนดว่าข้อมูลชั้นใดใช้ได้
ขั้นตอนที่ 2: คัดเลือกโมเดล Open-weight
เลือกโมเดลที่ไลเซนส์ใช้เชิงพาณิชย์ได้ ขนาดพอดีกับหน่วยความจำ GPU และตอบภาษาไทยได้ดีในชุดทดสอบจากงานจริง
ขั้นตอนที่ 3: เตรียม GPU Server ในประเทศไทย
เลือก GPU Server ของ THAI DATA CLOUD ที่มี NVIDIA Tesla T4 และ V100 ใน Data Center ไทย เริ่มต้น 33,210 บาท/เดือน ถ้าจะใช้ vLLM ให้เลือก T4 แล้วเตรียม Linux และไดรเวอร์ NVIDIA ตามที่เครื่องมือกำหนด
ขั้นตอนที่ 4: ติดตั้งตัวรันโมเดล
นำร่องด้วย Ollama เมื่อผู้ใช้พร้อมกันมากขึ้นจึงย้ายไป vLLM ผ่าน Docker Image ทางการ และเปิดให้เข้าถึงเฉพาะในเครือข่ายองค์กร
ขั้นตอนที่ 5: ติดตั้ง Open WebUI และกำหนดสิทธิ์
เชื่อม Open WebUI กับตัวรันโมเดล สร้างกลุ่มผู้ใช้ตามแผนก กำหนดสิทธิ์รายโมเดล และสร้างคลังความรู้จากเอกสาร
ขั้นตอนที่ 6: วางระบบความปลอดภัยและสำรองข้อมูล
จำกัดการเข้าถึงด้วย Firewall หรือ VPN ใช้ HTTPS เก็บ Log และสำรองข้อมูล หรือใช้บริการ Cybersecurity ที่มี SOC เฝ้าระวัง 24x7 และ Managed Firewall
ขั้นตอนที่ 7: วัดผลแล้วค่อยขยาย
ติดตามความแม่นยำ ความเร็ว และจำนวนผู้ใช้ เมื่อคุ้มค่าจึงเพิ่ม GPU หรือขยายงาน ระบบรอบข้างอย่างฐานข้อมูลวางบน Private Cloud ที่ข้อมูลอยู่ในประเทศได้
คำถามที่พบบ่อยเกี่ยวกับ Private AI
Private AI ต้องใช้ GPU เสมอไหม?
ไม่เสมอไป Ollama สั่งให้รันบน CPU ได้ แต่ช้ากว่า จึงเหมาะกับการทดลองโมเดลเล็ก ถ้ามีผู้ใช้หลายคนควรใช้ GPU เพราะหน่วยความจำ GPU กำหนดขนาดโมเดลที่รันได้
Private AI ช่วยเรื่อง PDPA ได้อย่างไร?
เมื่อรัน Private AI บนเซิร์ฟเวอร์ในไทย ข้อมูลที่ส่งให้ AI ไม่ต้องออกนอกประเทศ ซึ่งเป็นเรื่องที่ PDPA มีหลักเกณฑ์เฉพาะ แต่หน้าที่อื่นตามกฎหมายยังอยู่ ควรปรึกษาผู้เชี่ยวชาญด้านกฎหมาย
Private AI แพงกว่าการใช้โมเดลผ่าน API ไหม?
ขึ้นกับปริมาณใช้งาน API คิดตาม token จึงประหยัดเมื่อใช้น้อย ส่วน Private AI เป็นค่าเซิร์ฟเวอร์คงที่ เช่น GPU Server ของ THAI DATA CLOUD เริ่มต้น 33,210 บาท/เดือน จึงคุ้มเมื่อผู้ใช้มากและใช้ต่อเนื่อง
ควรเลือก Ollama หรือ vLLM?
Ollama เหมาะกับการเริ่มต้นและทีมเล็ก รองรับทั้ง T4 และ V100 ส่วน vLLM เหมาะกับผู้ใช้จำนวนมากพร้อมกัน แต่ต้องใช้ Linux และ GPU ที่มี Compute Capability 7.5 ขึ้นไป เช่น T4
สรุป: เริ่ม Private AI จากงานเล็กที่วัดผลได้
Private AI เหมาะกับข้อมูลที่ต้องอยู่ในองค์กรและงานที่ใช้ต่อเนื่อง แลกกับค่า GPU งานดูแล และการทดสอบคุณภาพโมเดล เริ่มจาก Ollama กับ Open WebUI บน GPU Server แล้วค่อยขยายด้วย vLLM
ต้องการวางระบบ Private AI บนคลาวด์ในประเทศไทย ติดต่อทีม THAI DATA CLOUD ปรึกษาฟรี
แหล่งข้อมูลอ้างอิง
Ollama Docs: Hardware support
vLLM Docs: GPU installation
Open WebUI Docs: Features
PDPC (สคส.): ประกาศหลักเกณฑ์ข้อมูลส่วนบุคคลที่ส่งหรือโอนไปต่างประเทศ ตามมาตรา 29