เมื่อองค์กรให้ AI อ่านอีเมล สรุปหน้าเว็บ หรือทำงานแทนในระบบ ภัยที่ต้องรู้จักคือ Prompt Injection การแฝงคำสั่งเพื่อให้ AI ทำตามผู้โจมตีแทนเจ้าของระบบ
บทความนี้อธิบายกลไก ความเสี่ยง และวิธีป้องกัน ตามเอกสารของ OWASP ชุมชนความปลอดภัยซอฟต์แวร์ และ NIST หน่วยงานมาตรฐานของสหรัฐฯ
สรุปสั้นสำหรับผู้บริหาร
คืออะไร: ข้อความที่หลอกให้ AI ทำงานผิดจากที่ตั้งใจ และเป็นความเสี่ยงอันดับ 1 ใน OWASP Top 10 for LLM Applications 2026
มีสองแบบ: แบบตรงที่ผู้ใช้พิมพ์เอง และแบบแฝงที่ซ่อนมากับเว็บ อีเมล หรือเอกสาร
อันตรายเมื่อไร: เมื่อ AI Agent มีสิทธิ์ส่งอีเมล เรียก API หรือแก้ข้อมูล
รับมืออย่างไร: ยังกันได้ไม่ 100% จึงต้องจำกัดสิทธิ์ ให้คนอนุมัติ และเฝ้าระวัง
Prompt Injection คืออะไร?
Prompt Injection คือช่องโหว่ที่ข้อความซึ่งโมเดล AI อ่าน ทั้งจากผู้ใช้ เอกสาร หรือหน้าเว็บ ทำให้โมเดลทำงานต่างจากที่นักพัฒนาตั้งใจ เช่น เปิดเผยข้อมูลหรือเรียกใช้เครื่องมือโดยไม่ได้รับอนุญาต
ต้นเหตุคือโมเดลภาษาขนาดใหญ่ (LLM) ไม่แยกคำสั่งออกจากข้อมูล NIST เทียบว่าคล้ายจุดอ่อนเบื้องหลังการโจมตีฐานข้อมูลแบบ SQL Injection แต่ OWASP ระบุว่ายังไม่มีวิธีแก้ที่ชัดเจนแบบที่ใช้กับ SQL Injection
Prompt Injection ทำงานอย่างไร?
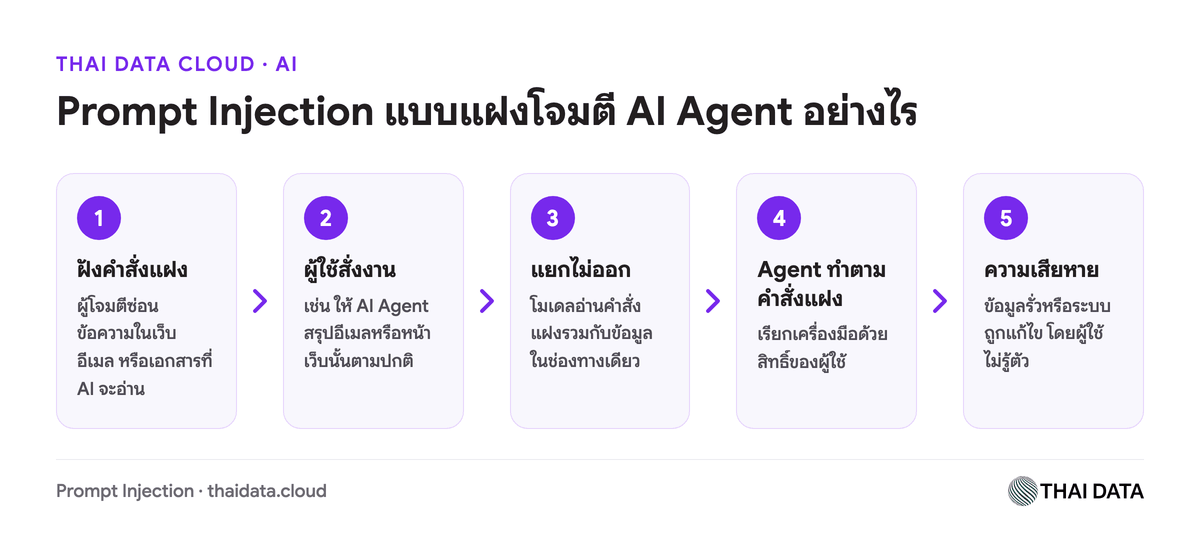
แบบตรง (Direct Prompt Injection)
ผู้ใช้พิมพ์ข้อความให้โมเดลทำงานผิดจากที่ออกแบบ เช่น สั่งแชตบอตให้เพิกเฉยต่อกฎ เปิดเผย System Prompt (คำสั่งตั้งต้นของระบบ) หรือค้นข้อมูลที่ตนไม่มีสิทธิ์
แบบแฝง (Indirect Prompt Injection)
คำสั่งซ่อนในเนื้อหาที่ AI ไปอ่าน เช่น หน้าเว็บ อีเมล เอกสาร ฐานความรู้ของระบบ RAG หรือผลลัพธ์ของเครื่องมือ ผู้โจมตีเป็นบุคคลที่สาม ส่วนผู้ใช้ไม่เห็นคำสั่งนั้นเลย
คำสั่งแฝงอาจซ่อนในส่วนที่ไม่แสดงผล ใช้อักขระที่มองไม่เห็น หรือฝังในรูปภาพ ผู้โจมตีไม่ต้องเจาะระบบ แค่วางข้อความในที่ที่ AI จะอ่าน แล้ว AI ก็ลงมือแทนด้วยสิทธิ์ของผู้ใช้
ทำไม Prompt Injection อันตรายขึ้นเมื่อ AI Agent มีเครื่องมือ?
แชตบอตที่ตอบได้อย่างเดียว ผลกระทบส่วนใหญ่อยู่ที่คำตอบ แต่ AI Agent ที่อ่านอีเมล เรียก API หรือเชื่อมเครื่องมือผ่านมาตรฐานอย่าง MCP จะเปลี่ยนคำสั่งแฝงเป็นการกระทำจริงในทุกระบบที่ Agent เข้าถึงได้
ข้อมูลรั่ว: ส่งต่ออีเมลให้ผู้โจมตี หรือแนบข้อมูลไปกับ URL ที่ชี้ไปเว็บภายนอก
การกระทำที่ไม่ได้สั่ง: ส่งอีเมล แก้หรือลบข้อมูล หรือรันคำสั่งบนเซิร์ฟเวอร์
ผลลัพธ์ถูกบิดเบือน: สรุปผิด ซ่อนข้อมูล หรือแนะนำลิงก์อันตราย
ฝังตัวข้ามรอบ: คำสั่งที่ถูกเขียนลงหน่วยความจำของ Agent ส่งผลทุกครั้งที่ถูกดึงมาใช้
OWASP เรียกปัญหาที่ Agent มีฟังก์ชัน สิทธิ์ หรือความเป็นอิสระเกินจำเป็นว่า Excessive Agency (LLM03:2026) ซึ่งเป็นสิ่งที่ทำให้ Prompt Injection เกิดความเสียหายจริง
OWASP จัด Prompt Injection ไว้อันดับเท่าไหร่?
ใน OWASP Top 10 for LLM Applications 2026 ที่ OWASP เผยแพร่บนเว็บไซต์ในปี 2569 Prompt Injection ยังอยู่อันดับ 1 ในชื่อ LLM01:2026 เช่นเดียวกับฉบับ 2025 ความเสี่ยงที่เกี่ยวข้องได้แก่
LLM02:2026 Sensitive Information Disclosure: ข้อมูลสำคัญรั่วผ่านผลลัพธ์ของโมเดล
LLM03:2026 Excessive Agency: ขยับขึ้นจากอันดับ 6 ในฉบับ 2025 เพราะความเสียหายจริงเกิดกับระบบแบบ Agent
LLM08:2026 Hidden Context Exposure: ชื่อใหม่ของ System Prompt Leakage
OWASP ระบุว่ายังไม่มีกลไกป้องกัน Prompt Injection ที่เชื่อถือได้ และ NIST ชี้ว่ามาตรการที่มีอยู่ยังไม่ครอบคลุมทุกเทคนิค จึงควรออกแบบระบบโดยถือว่าคำสั่งแฝงหลุดเข้ามาได้
ตัวอย่างสถานการณ์ Prompt Injection ในองค์กรมีอะไรบ้าง?
ตัวอย่างปรับจาก OWASP และ NIST โดยไม่ลงรายละเอียดวิธีโจมตี
ผู้ช่วยจัดการอีเมล: อีเมลจากภายนอกซ่อนคำสั่งให้ AI ส่งต่ออีเมลสำคัญออกไป ถ้า Agent ส่งได้เองโดยไม่ต้องขออนุมัติ ข้อมูลก็รั่ว
AI สรุปหน้าเว็บ: หน้าเว็บมีคำสั่งแฝงให้ AI แทรกรูปภาพที่ URL แนบเนื้อหาบทสนทนาไปยังเว็บของผู้โจมตี
ฐานความรู้ขององค์กร: เอกสารที่ถูกแก้ในคลังของระบบ RAG ทำให้คำตอบผิดไปตามที่ผู้โจมตีต้องการ
ช่องทางที่ดูน่าเชื่อถือ: ข้อความในแบบฟอร์มหรือตั๋วแจ้งปัญหาถูก Agent ที่มีสิทธิ์สูงอ่าน แล้วทำสิ่งที่ผู้โจมตีทำเองไม่ได้
ป้องกัน Prompt Injection อย่างไร?
OWASP แนะนำให้ป้องกันหลายชั้น (Defense in Depth) โดยเน้นมาตรการที่จำกัดความเสียหายเมื่อการโจมตีสำเร็จ
ชั้นที่ 1: ให้สิทธิ์น้อยที่สุด (Least Privilege)
ให้ Agent ใช้เฉพาะเครื่องมือและสิทธิ์ที่จำเป็น เช่น ผู้ช่วยสรุปอีเมลอ่านได้อย่างเดียว ให้แอปถือ API Key เองโดยไม่ส่งให้โมเดล และให้ระบบปลายทางตรวจสิทธิ์เอง ไม่ปล่อยให้ AI ตัดสิน
ชั้นที่ 2: ให้คนอนุมัติงานสำคัญ
งานที่ย้อนกลับไม่ได้หรือส่งออกภายนอก เช่น ส่งอีเมลถึงลูกค้า จ่ายเงิน หรือลบข้อมูล ต้องรอคนยืนยันก่อน (Human-in-the-loop) โดยแสดงสิ่งที่ AI จะทำอย่างละเอียด
ชั้นที่ 3: แยกเนื้อหาภายนอกออกจากคำสั่ง
ติดป้ายแหล่งที่มาของเนื้อหาภายนอก และใช้หลัก Rule of Two ที่ OWASP อ้างถึง คือ Agent ที่ทั้งรับข้อมูลไม่น่าเชื่อถือ เข้าถึงข้อมูลสำคัญ และแก้ไขระบบหรือสื่อสารออกภายนอกได้ ต้องให้คนอนุมัติทุกการกระทำ
ชั้นที่ 4: ตรวจผลลัพธ์ก่อนใช้ต่อ
ใช้โค้ดตรวจทุกคำตอบก่อนส่งต่อ เช่น โครงสร้างข้อมูลถูกต้องหรือไม่ มีลิงก์ไปโดเมนแปลกปลอมหรือไม่ และตัดอักขระที่มองไม่เห็นออก
ชั้นที่ 5: เฝ้าระวังและเก็บ Log
บันทึกทุกการเรียกเครื่องมือของ Agent และตั้งเกณฑ์จำกัดจำนวนการเรียก (Rate Limit) เพื่อหยุดหรือส่งให้คนตรวจก่อนความเสียหายลุกลาม
ชั้นที่ 6: ทดสอบแบบ Red Team
จำลองการโจมตีอย่างสม่ำเสมอ โดยให้ผู้ทดสอบรู้รายละเอียดระบบป้องกัน เพราะ OWASP เตือนว่าการทดสอบแบบตายตัวให้ภาพที่ดีเกินจริง
มาตรการเหล่านี้ควรเขียนไว้ในนโยบาย AI Governance ขององค์กรด้วย
เสริมการป้องกัน Prompt Injection ด้วย THAI DATA CLOUD
การออกแบบระบบ AI คือด่านแรก ส่วนการเฝ้าระวังและทดสอบต้องทำต่อเนื่อง
Cybersecurity: SOC เฝ้าระวัง 24x7, Managed Firewall, เก็บ Log ตาม พ.ร.บ.คอมพิวเตอร์ และ Pentest ทดสอบเจาะระบบ
Private Cloud: บน Proxmox VE ข้อมูลอยู่ในประเทศ สำหรับวาง AI Agent ในสภาพแวดล้อมที่ควบคุมได้
Cloud Database Server: ฐานข้อมูลพร้อม SSL, Anti-DDoS และ WAF ควรสร้างบัญชีแยกให้ Agent ด้วยสิทธิ์เท่าที่จำเป็น
คำถามที่พบบ่อยเกี่ยวกับ Prompt Injection
Prompt Injection ต่างจาก Jailbreak อย่างไร?
Jailbreak คือส่วนหนึ่งของ Prompt Injection ที่มุ่งให้โมเดลละเมิดกฎความปลอดภัย ส่วน Prompt Injection กว้างกว่า รวมถึงการสั่งให้ AI Agent ดึงข้อมูลหรือเรียกเครื่องมือแทนผู้โจมตี
ใช้โมเดลที่เก่งขึ้นหรือ Private AI แล้วปลอดภัยจาก Prompt Injection ไหม?
ไม่ปลอดภัยโดยอัตโนมัติ OWASP ระบุว่าช่องโหว่นี้เป็นธรรมชาติของ Generative AI ในปัจจุบัน ส่วนการรันโมเดลบนเซิร์ฟเวอร์ขององค์กรช่วยคุมตำแหน่งข้อมูล แต่ยังต้องจำกัดสิทธิ์ ให้คนอนุมัติ และตรวจผลลัพธ์เหมือนเดิม
ใช้แค่แชตบอตถามตอบ ต้องกังวลเรื่อง Prompt Injection ไหม?
ความเสี่ยงต่ำกว่า Agent ที่มีเครื่องมือ แต่ยังมีอยู่ เช่น ผู้ใช้หลอกให้บอตเปิดเผย System Prompt หรือบอตอ่านเอกสารที่มีคำสั่งแฝงจนตอบผิด
ควรทดสอบ Prompt Injection เมื่อไร?
ก่อนเปิดใช้งานจริง และทุกครั้งที่เพิ่มเครื่องมือ เปลี่ยนสิทธิ์ หรือเปลี่ยนโมเดล โดยให้ผู้ทดสอบรู้รายละเอียดระบบป้องกัน
สรุป: ออกแบบระบบให้รับมือ Prompt Injection ได้ตั้งแต่วันแรก
Prompt Injection ยังไม่มีวิธีแก้ขาด OWASP ฉบับ 2026 จึงแนะนำว่าอย่าพยายามสร้างโมเดลที่หลอกไม่ได้ แต่ให้ออกแบบระบบรอบโมเดล เพื่อให้เมื่อโมเดลถูกหลอก จะไม่มีอะไรสำคัญเสียหาย
เริ่มจาก Agent ที่อ่านได้อย่างเดียว แล้วค่อยเพิ่มสิทธิ์เมื่อมีการอนุมัติโดยคนและ Log รองรับ
ต้องการวางระบบ AI Agent ให้ปลอดภัย หรือเสริมการเฝ้าระวังด้วย SOC และ Pentest ติดต่อทีม THAI DATA CLOUD ปรึกษาฟรี
แหล่งข้อมูลอ้างอิง
OWASP GenAI Security Project: OWASP GenAI LLM Top 10 2026
OWASP GenAI Security Project: LLM01:2025 Prompt Injection