แชตบอต AI ทั่วไปไม่รู้ข้อมูลภายในของบริษัทคุณ และบางครั้งแต่งคำตอบที่ฟังดูน่าเชื่อขึ้นมาเอง RAG แก้ปัญหานี้ด้วยการให้ AI ค้นเอกสารขององค์กรก่อนตอบ พร้อมบอกที่มา
บทความนี้อธิบายหลักการ ความต่างจากการเทรนโมเดลเพิ่ม (Fine-tuning) วิธีสร้าง การคุมสิทธิ์ และการวัดผล
สรุปสั้นสำหรับผู้บริหาร
- หลักการ: ค้นเอกสารที่เกี่ยวข้องก่อน แล้วให้ AI ตอบจากเนื้อหานั้นพร้อมแหล่งอ้างอิง
- ข้อดี: ลดคำตอบที่แต่งขึ้นเอง อัปเดตความรู้ได้โดยไม่ต้องเทรนใหม่
- เหมาะกับ: คลังความรู้ภายใน คำถามนโยบาย HR และงานบริการลูกค้า
- ต้องระวัง: คุณภาพเอกสารและการกรองสิทธิ์ตั้งแต่ขั้นค้นหา
- เริ่มต้น: นำร่องหนึ่งเรื่องด้วย Open WebUI, Ollama และ Qdrant
RAG คืออะไร?
RAG (Retrieval-Augmented Generation) คือเทคนิคที่ให้โมเดลภาษาขนาดใหญ่ (LLM) ค้นข้อมูลที่เกี่ยวข้องจากคลังเอกสารก่อน แล้วใช้เนื้อหานั้นประกอบการตอบ AI จึงตอบจากข้อมูลจริงขององค์กรและอ้างอิงที่มาได้
ชื่อ RAG มาจากงานวิจัยของ Patrick Lewis และคณะ (NeurIPS 2020) ที่ชี้ว่าโมเดลซึ่งพึ่งความรู้ในตัวอย่างเดียวแก้ไขความรู้ได้ยาก และอาจเกิดอาการหลอน (Hallucination) หรือการสร้างข้อมูลที่ไม่จริง
RAG ทำงานอย่างไร?
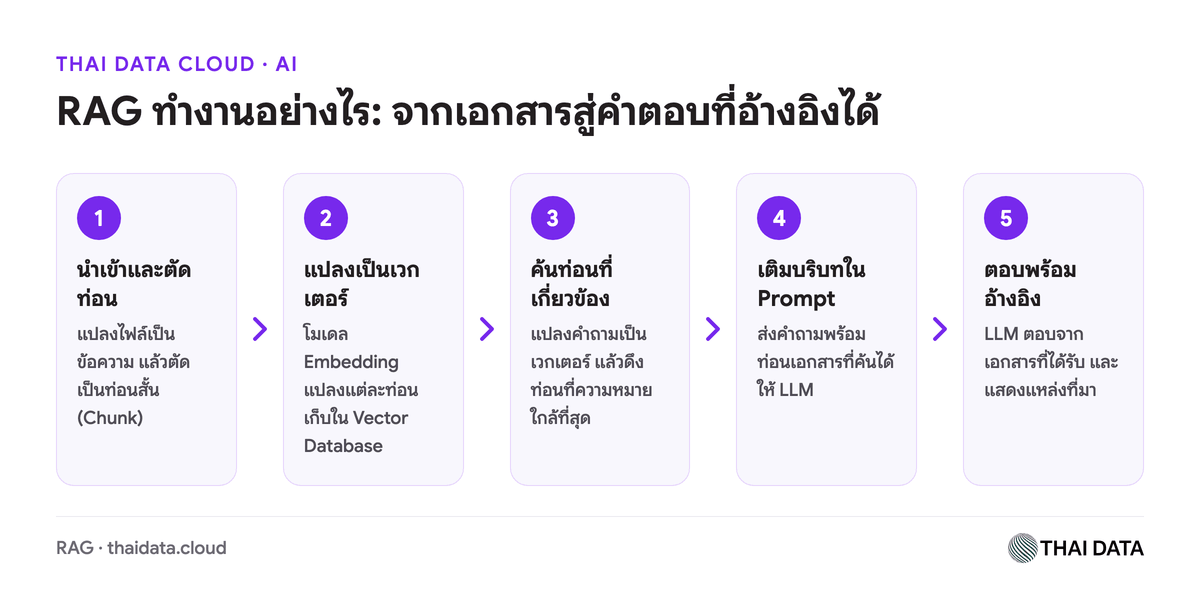
- นำเข้าและตัดท่อน (Chunking): ดึงข้อความจากไฟล์แล้วแบ่งเป็นท่อนสั้น งานต้นฉบับใช้ท่อนละ 100 คำ
- แปลงเป็นเวกเตอร์ (Embedding): โมเดล Embedding แปลงแต่ละท่อนเป็นชุดตัวเลขที่แทนความหมาย
- จัดเก็บ: บันทึกเวกเตอร์พร้อมข้อมูลกำกับ (Metadata) เช่น แผนกและชั้นความลับ ลงใน Vector Database
- ค้นคืน (Retrieve): แปลงคำถามด้วยโมเดลเดียวกัน แล้วดึงท่อนที่ความหมายใกล้ที่สุด
- เติมบริบท (Augment): ใส่ท่อนที่ค้นได้ลงใน Prompt (ข้อความสั่งงาน) และกำชับให้ตอบจากเนื้อหานี้
- สร้างคำตอบ (Generate): LLM เรียบเรียงคำตอบพร้อมแหล่งอ้างอิง
ทำไม RAG ช่วยลดคำตอบที่แต่งขึ้นเอง?
RAG วางข้อเท็จจริงไว้ตรงหน้าโมเดลแทนการให้เดาจากความจำ ในการประเมินเชิงคุณภาพของงานวิจัยต้นฉบับ โมเดล RAG เกิดอาการหลอนน้อยกว่าและตอบถูกตามข้อเท็จจริงบ่อยกว่าโมเดล BART ที่ใช้เพียงความรู้ในตัว
ทีมวิจัยยังถามถึงผู้นำ 82 ตำแหน่งที่เปลี่ยนตัวระหว่างปี ค.ศ. 2016-2018 เมื่อใช้ดัชนี Wikipedia ที่ตรงปี โมเดลตอบถูก 70% และ 68% แต่ถ้าใช้ดัชนีผิดปีตอบถูกเพียง 12% และ 4% แค่เปลี่ยนคลังข้อมูลก็อัปเดตความรู้ได้
แต่ RAG ไม่ได้ขจัดคำตอบผิด หากค้นผิดท่อนหรือเอกสารล้าสมัย คำตอบก็ผิดได้
RAG ต่างจาก Fine-tuning อย่างไร?
Fine-tuning ปรับน้ำหนักในโมเดลด้วยข้อมูลองค์กร ส่วน RAG ส่งความรู้ไปพร้อมคำถามโดยไม่แตะโมเดล
- การอัปเดต: RAG แค่แก้เอกสาร ส่วน Fine-tuning ต้องเทรนใหม่
- การอ้างอิง: RAG ชี้ได้ว่าคำตอบมาจากเอกสารใด ส่วน Fine-tuning ชี้ไม่ได้
- การคุมสิทธิ์: RAG กรองเอกสารตามสิทธิ์ผู้ถามได้ ส่วนความรู้ในโมเดลแยกสิทธิ์รายคนไม่ได้
- เหมาะกับ: RAG สำหรับข้อมูลที่เปลี่ยนบ่อย Fine-tuning สำหรับปรับรูปแบบและน้ำเสียงคำตอบ และใช้ร่วมกันได้
องค์กรใช้ RAG ทำอะไรได้บ้าง?
- คลังความรู้ภายใน: ถามเรื่องคู่มือและขั้นตอนงาน ได้คำตอบพร้อมลิงก์เอกสาร
- นโยบาย HR: ตอบเรื่องวันลาและสวัสดิการโดยอ้างข้อในระเบียบ
- บริการลูกค้า: ตอบจากคู่มือสินค้า หรือร่างคำตอบให้พนักงานตรวจ
คุมสิทธิ์และความปลอดภัยของข้อมูลในระบบ RAG อย่างไร?
สิ่งที่อยู่ใน Prompt อาจหลุดไปในคำตอบ การสั่งห้ามเปิดเผยจึงไม่พอ OWASP จัดความเสี่ยงนี้ไว้ในหัวข้อ LLM08:2025 Vector and Embedding Weaknesses และแนะนำดังนี้
- แบ่งตามสิทธิ์: ติดป้ายแผนกและชั้นความลับให้ทุกท่อน แล้วกรองตามสิทธิ์ผู้ถามทุกครั้ง เช่น ใน Qdrant ใส่ฟิลด์ระบุกลุ่มไว้ใน Payload (ข้อมูลกำกับ)
- ตรวจเอกสารก่อนเข้าคลัง: ข้อความซ่อน เช่น ตัวอักษรสีขาวบนพื้นขาว อาจแฝงคำสั่งแบบ Prompt Injection
- เก็บบันทึกการค้นคืน (Log): ใครได้เอกสารใดไป แบบแก้ย้อนหลังไม่ได้
- ปกป้องเวกเตอร์: เวกเตอร์อาจถูกย้อนกลับจนเผยเนื้อหาต้นฉบับ จึงต้องคุมสิทธิ์เท่าตัวเอกสาร
ถ้าเอกสารมีข้อมูลส่วนบุคคล ต้องคำนึงถึงกฎหมายคุ้มครองข้อมูลส่วนบุคคล (PDPA) และควรปรึกษาผู้เชี่ยวชาญกฎหมาย
สร้างระบบ RAG ด้วย Open WebUI, Ollama และ Qdrant ทำอย่างไร?
ตัวอย่างนี้ใช้ Open WebUI (หน้าจอแชต AI ที่มีระบบ RAG ในตัว) Ollama (รันโมเดลบนเซิร์ฟเวอร์ตัวเอง) และ Qdrant (ฐานข้อมูลเวกเตอร์)
ขั้นตอนที่ 1: เตรียมเอกสารนำร่อง
เลือกเรื่องเดียว เช่น ระเบียบ HR เก็บเฉพาะฉบับล่าสุด ระบุสิทธิ์การอ่าน และแปลงไฟล์สแกนเป็นข้อความ (OCR)
ขั้นตอนที่ 2: เลือกโมเดล
ถ้าข้อมูลห้ามออกนอกองค์กร ให้รันโมเดลเองด้วย Ollama ส่วนโมเดล Embedding นั้น Open WebUI รองรับทั้งจาก Ollama และ OpenAI
Open WebUI เตือนว่าบน GPU ที่หน่วยความจำต่ำกว่า 24 GiB Ollama ตั้งความยาวบริบทไว้ 4,096 token (หน่วยนับข้อความ) ซึ่งจำกัดประสิทธิภาพ RAG มาก ควรปรับเพิ่ม
ขั้นตอนที่ 3: ตั้งค่าการตัดท่อนและการค้นหา
ที่ Settings → Admin → Documents กำหนดโมเดล Embedding, Chunk Size (ขนาดท่อน) และ Chunk Overlap (ส่วนซ้อนระหว่างท่อน) ถ้าต้องค้นรหัสสินค้าแบบตรงตัว ให้เปิด Hybrid Search ที่ผสาน BM25 (ค้นด้วยคำสำคัญ) กับการค้นด้วยความหมาย
ขั้นตอนที่ 4: เลือกที่เก็บเวกเตอร์
ช่วงนำร่องใช้ที่เก็บเวกเตอร์ของ Open WebUI ได้เลย เมื่อพร้อมจึงเชื่อม Qdrant, Milvus หรือ pgvector (บางส่วนยังเป็นฟีเจอร์ทดลอง) โดยเวกเตอร์ต้องมาจากโมเดล Embedding เดียวกัน
ขั้นตอนที่ 5: สร้างคลังความรู้และทดสอบ
อัปโหลดเอกสารเข้า Knowledge แล้วพิมพ์ # ในแชตเพื่อเลือกใช้ คำตอบจะแสดงการอ้างอิง (Citation) ให้ผู้ใช้กลุ่มแรกช่วยตรวจ
วัดคุณภาพคำตอบของ RAG อย่างไร?
สร้างชุดคำถามจริงพร้อมคำตอบที่ผู้เชี่ยวชาญยืนยัน แล้ววัดซ้ำทุกครั้งที่ปรับระบบ ดังนี้
- การค้นคืน: ท่อนที่มีคำตอบถูกดึงมาหรือไม่
- ความซื่อตรง (Faithfulness): ทุกข้อความในคำตอบมีเอกสารรองรับหรือไม่
- ความถูกต้องและการอ้างอิง: ตรงกับคำตอบมาตรฐาน และลิงก์ชี้ถูกเอกสารหรือไม่
- การยอมรับว่าไม่รู้: ตอบว่าไม่พบข้อมูลแทนการเดาหรือไม่
วางระบบ RAG บนคลาวด์ในประเทศไทยกับ THAI DATA CLOUD
คลังความรู้ควรอยู่บนคลาวด์ที่รู้ชัดว่าข้อมูลอยู่ที่ไหนและใครดูแล
- GPU Server: NVIDIA Tesla T4 / V100 ใน Data Center ประเทศไทย รันโมเดลด้วย Ollama หรือ vLLM ที่รับผู้ใช้พร้อมกันได้มาก เริ่มต้น 33,210 บาท/เดือน
- Cloud Server: สำหรับ Open WebUI และ Qdrant ปรับเพิ่มลด CPU/RAM ได้เอง SLA 99.9% เริ่มต้น 90 บาท/เดือน
- Private Cloud: ข้อมูลอยู่ในประเทศ รองรับ PDPA เหมาะกับ Private AI ที่เก็บทั้งโมเดลและข้อมูลในองค์กร
- Cybersecurity: SOC เฝ้าระวัง 24x7 และ Backup กัน Ransomware
คำถามที่พบบ่อยเกี่ยวกับ RAG
RAG ทำให้ AI ไม่ตอบผิดเลยใช่ไหม?
ไม่ใช่ RAG ลดคำตอบที่แต่งขึ้นเอง แต่ยังผิดได้ถ้าค้นไม่เจอท่อนที่ถูกหรือเอกสารล้าสมัย ควรให้ระบบตอบว่าไม่พบข้อมูลเมื่อเอกสารไม่มีคำตอบ และให้คนตรวจเรื่องสำคัญ
เมื่อเอกสารเปลี่ยน ต้องเทรนโมเดลใหม่ไหม?
ไม่ต้อง แค่นำเข้าฉบับใหม่และลบฉบับเก่า ยกเว้นเมื่อเปลี่ยนโมเดล Embedding ที่ต้องทำดัชนีใหม่ทั้งหมด เพราะเวกเตอร์ต่างโมเดลเทียบกันไม่ได้
ระบบ RAG ต้องใช้ GPU ไหม?
ไม่เสมอไป ถ้าเรียกโมเดลผ่าน API ส่วน Open WebUI และฐานข้อมูลเวกเตอร์รันบนเซิร์ฟเวอร์ทั่วไปได้ แต่ถ้ารันโมเดลภาษาเองควรใช้ GPU เพื่อให้ตอบได้เร็วพอ
ข้อมูลลับของบริษัทจะรั่วผ่าน RAG ได้ไหม?
รั่วได้ถ้าระบบดึงเอกสารที่ผู้ถามไม่มีสิทธิ์เข้าไปใน Prompt จึงต้องกรองสิทธิ์ตั้งแต่ขั้นค้นหา และถ้าใช้โมเดลภายนอก ท่อนเอกสารจะถูกส่งออกไปด้วย ข้อมูลอ่อนไหวจึงควรใช้โมเดลในองค์กร
สรุป: เริ่ม RAG จากโจทย์เล็กที่วัดผลได้
RAG ให้ AI ตอบจากเอกสารจริงและอ้างอิงได้ ความสำเร็จขึ้นกับคุณภาพเอกสาร การกรองสิทธิ์ และการวัดผลสม่ำเสมอ
ต้องการวางระบบ RAG บนคลาวด์ในประเทศไทย ติดต่อทีม THAI DATA CLOUD ปรึกษาฟรี
แหล่งข้อมูลอ้างอิง
สอบถามข้อมูลบริการ