
เมื่อพนักงานค้นว่า "ลืมรหัสผ่านอีเมล" คำตอบอาจอยู่ในเอกสารชื่อ "ขั้นตอนรีเซ็ตรหัสผ่าน" ที่ไม่มีคำว่า "ลืม" เลย การค้นหาด้วยความหมายแบบนี้คือหน้าที่ของ Vector Database
บทความนี้อธิบายหลักการทำงาน วิธีเลือกระหว่าง Qdrant, Milvus และ pgvector และการดูแลระบบให้ปลอดภัย
สรุปสั้นสำหรับผู้บริหาร
- คืออะไร: ฐานข้อมูลที่เก็บความหมายเป็นเวกเตอร์ และค้นรายการที่ใกล้เคียงที่สุดได้เร็ว
- ใช้ทำอะไร: ชั้นค้นหาของ AI ที่ตอบจากเอกสาร (RAG)
- หัวใจทางเทคนิค: ดัชนีแบบประมาณอย่าง HNSW ที่แลกความแม่นยำเล็กน้อยกับความเร็ว
- ตัวเลือกหลัก: pgvector ต่อยอด PostgreSQL, Qdrant เด่นเรื่องกรองเงื่อนไข และ Milvus สำหรับข้อมูลขนาดใหญ่มาก
- อย่าลืม: สำรองข้อมูลและคุมสิทธิ์เหมือนฐานข้อมูลหลัก
Vector Database คืออะไร?
Vector Database คือฐานข้อมูลสำหรับเก็บและค้นหาเวกเตอร์ หรือชุดตัวเลขที่โมเดล AI สร้างขึ้นแทนความหมายของข้อความหรือภาพ โดยหารายการที่ใกล้คำค้นที่สุด จึงค้นด้วยความหมายได้แม้ใช้คำต่างกัน
ในระบบ RAG Vector Database คือชั้นที่หาท่อนเอกสารที่เกี่ยวข้องก่อนส่งให้ LLM เรียบเรียงคำตอบ ถ้าค้นผิด คำตอบก็มีโอกาสผิดตาม
Vector Database ทำงานอย่างไร?
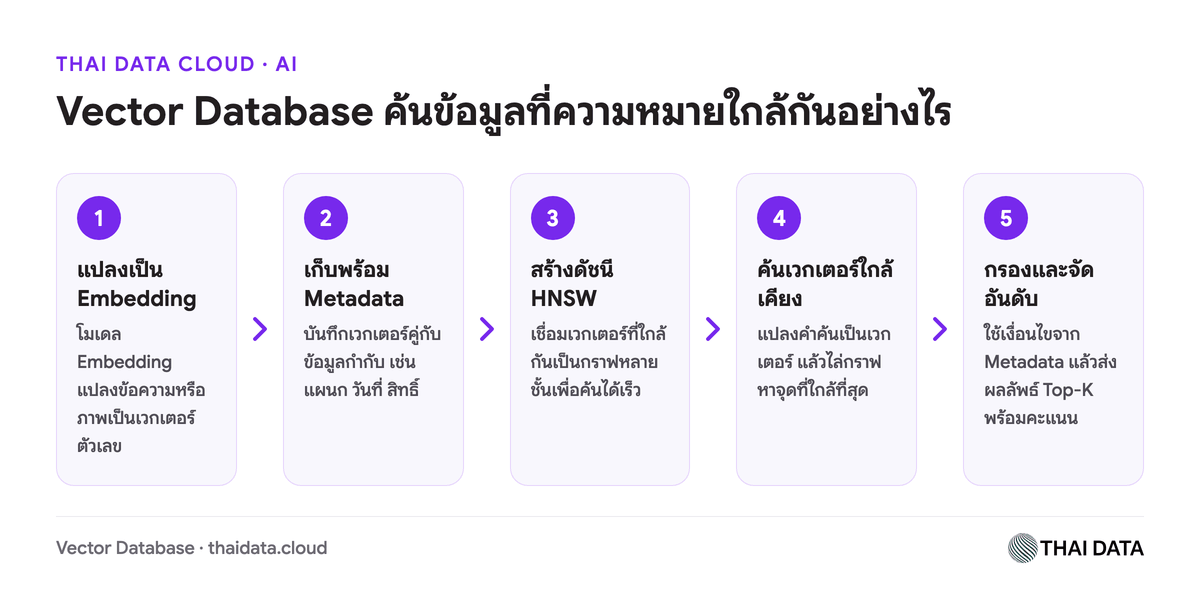
แผนภาพแสดงห้าขั้นหลักของการทำงาน เริ่มจาก Embedding
Embedding คืออะไร?
Embedding คือการแปลงข้อมูลเป็นเวกเตอร์ด้วยโมเดล Embedding ที่ถูกฝึกให้ข้อความที่ความหมายใกล้กันได้เวกเตอร์ใกล้กัน เช่น "ลืมรหัสผ่าน" จะอยู่ใกล้ "รีเซ็ตรหัสผ่าน" มากกว่า "รหัสสินค้า"
เวกเตอร์ในชุดเดียวกันต้องมาจากโมเดลเดียวกันและมีจำนวนมิติเท่ากัน ถ้าเปลี่ยนโมเดลต้องสร้างเวกเตอร์ใหม่ทั้งหมด
Vector Database วัดความใกล้ของเวกเตอร์อย่างไร?
การค้นหาความคล้าย (Similarity Search) คือการหาเวกเตอร์ K ตัวที่ใกล้คำค้นที่สุด ตัววัดที่พบบ่อยในงานข้อความคือ Cosine Similarity ซึ่งดูมุมระหว่างเวกเตอร์ ยิ่งค่าเข้าใกล้ 1 ความหมายยิ่งใกล้กัน
ใน pgvector ตัวดำเนินการ <=> ให้ Cosine Distance (1 ลบ Cosine Similarity) <-> ให้ระยะแบบยุคลิด (L2) และ <#> ให้ผลคูณภายในแบบติดลบ ควรเลือกตัววัดตามคำแนะนำของผู้พัฒนาโมเดล Embedding
ทำไม Vector Database ต้องใช้ดัชนีแบบ ANN อย่าง HNSW?
การเทียบคำค้นกับทุกเวกเตอร์ได้ Recall (สัดส่วนของผลลัพธ์ที่ใกล้ที่สุดจริงที่ค้นเจอ) สมบูรณ์ และเป็นค่าเริ่มต้นของ pgvector แต่ช้าลงตามปริมาณข้อมูล ดัชนีแบบ ANN (Approximate Nearest Neighbor) จึงยอมแลก Recall บางส่วนกับความเร็ว
HNSW ทำงานอย่างไร?
HNSW (Hierarchical Navigable Small World) มาจากงานวิจัยของ Malkov และ Yashunin ที่เผยแพร่บน arXiv ปี 2016 โครงสร้างเป็นกราฟหลายชั้น ชั้นบนมีจุดน้อยและเส้นเชื่อมยาว ชั้นล่างหนาแน่นและเชื่อมจุดที่ใกล้กัน
การค้นเริ่มจากชั้นบนเพื่อเข้าใกล้เป้าหมายเร็ว ๆ แล้วลงทีละชั้นเพื่อค้นละเอียด คล้ายดูแผนที่จากระดับประเทศลงไปถึงถนน ผู้วิจัยรายงานว่าเวลาค้นเพิ่มแบบลอการิทึมตามขนาดข้อมูล
ปรับสมดุลความเร็วกับความแม่นยำอย่างไร?
ใน Qdrant ค่า m (จำนวนเส้นเชื่อมต่อจุด ค่าเริ่มต้น 16) และ ef_construct (จำนวนเพื่อนบ้านที่พิจารณาตอนสร้างดัชนี ค่าเริ่มต้น 100) ยิ่งสูงยิ่งแม่น แต่ใช้พื้นที่หรือเวลาสร้างมากขึ้น
ใน pgvector ค่า hnsw.ef_search เริ่มต้นที่ 40 ยิ่งสูง Recall ยิ่งดีแต่ช้าลง ส่วนดัชนี IVFFlat ที่แบ่งเวกเตอร์เป็นกลุ่ม สร้างเร็วและใช้หน่วยความจำน้อยกว่า HNSW แต่สมดุลความเร็วกับ Recall ด้อยกว่า
การกรองด้วย Metadata ใน Vector Database สำคัญแค่ไหน?
คำค้นจริงมักมีเงื่อนไขพ่วง เช่น เฉพาะแผนกบัญชี หรือเฉพาะเอกสารที่ผู้ถามมีสิทธิ์ ซึ่งเก็บเป็นข้อมูลกำกับ (Metadata) คู่กับเวกเตอร์
- Qdrant: เรียกข้อมูลกำกับว่า Payload ถ้าสร้าง Payload Index (ดัชนีของฟิลด์ที่ใช้กรอง) ไว้ Filterable HNSW จะเพิ่มเส้นเชื่อมในกราฟตามค่าที่ทำดัชนี จึงกรองระหว่างค้นได้ ควรสร้างก่อนนำเข้าข้อมูล
- pgvector: ใช้ WHERE ของ SQL ได้ แต่กับดัชนีแบบประมาณ การกรองเกิดหลังสแกนดัชนี เงื่อนไขที่ตรงกับข้อมูล 10% อาจได้ผลเฉลี่ยเพียง 4 แถวที่ค่าเริ่มต้น ตั้งแต่เวอร์ชัน 0.8.0 เปิด Iterative Index Scan ให้สแกนต่อจนได้ผลพอได้
- Milvus: ค้นแบบ ANN ภายใต้เงื่อนไขกรองได้ และแยกข้อมูลหลายกลุ่มผู้ใช้ (Multi-tenancy) ได้ตั้งแต่ระดับฐานข้อมูลถึง Partition Key