
เมื่อวันที่ 22 กันยายน 2569 Anthropic เปิดตัว Claude Opus 5.5 โมเดลแรกของตระกูล Claude 5.5 ที่ทำคะแนนสูงกว่า Claude Opus 5 ในทุกการทดสอบที่ประกาศ และยังนำ Claude Fable 5.1 รุ่นใหญ่ที่ราคาสูงกว่าถึง 2.5 เท่า
Anthropic ระบุว่าที่ค่าตั้งต้น งานทั่วไปบน Claude Opus 5.5 มีค่าใช้จ่ายรวมต่ำกว่า Opus 5 ราว 40% เพราะนอกจากราคาจะลดลง โมเดลยังใช้ token น้อยลงในงานเดียวกัน
สรุปสั้นสำหรับผู้บริหาร
- เก่งขึ้น: นำทั้ง Opus 5 และ Fable 5.1 ในงานเขียนโค้ดแบบ Agent งานเอกสารเชิงวิเคราะห์ และการอ่านกราฟ
- ถูกลง: $4 / $20 ต่อ 1 ล้าน token (Input / Output) ลดลง 20% จาก Opus 5
- เร็วขึ้น: สร้างคำตอบเร็วกว่า Opus 5 มากกว่า 30%
- ใช้ได้ทันที: แอป Claude, Claude Code, Claude API และคลาวด์ของ AWS, Google Cloud และ Microsoft Azure
- นักพัฒนาต้องรู้: ปิดโหมดคิด (Thinking) ไม่ได้แล้ว และค่า effort เริ่มต้นเปลี่ยนเป็น medium
Claude Opus 5.5 คืออะไร?
Claude Opus 5.5 คือโมเดล AI รุ่นล่าสุดในสาย Opus ของ Anthropic เปิดตัว 22 กันยายน 2569 สำหรับงานเขียนโค้ดแบบ Agent และงานวิเคราะห์ ทำคะแนนเหนือ Opus 5 และ Fable 5.1 ในผลที่ประกาศ โดยราคาต่อ token ถูกกว่า Opus 5 ราว 20%
ในตระกูล Claude มีตั้งแต่ Haiku ที่เล็กและประหยัด Sonnet ที่สมดุล Opus สำหรับงานซับซ้อน ไปจนถึง Fable ที่ใหญ่ที่สุด ส่วน Sonnet 5.5 และ Haiku 5.5 จะตามมาในอีกไม่กี่สัปดาห์
- Context Window: 1 ล้าน token อ่านเอกสารหรือโค้ดจำนวนมากได้ในครั้งเดียว
- ความยาวคำตอบสูงสุด: 128,000 token
- ระดับการคิด (Effort): low, medium, high, xhigh และ max โดยค่าเริ่มต้นคือ medium
- ข้อมูลความรู้ (Knowledge Cutoff): ถึงเดือนมิถุนายน 2569
- ชื่อโมเดลใน API:
claude-opus-5-5
ไฮไลต์ความสามารถใหม่ของ Claude Opus 5.5
1. เขียนโค้ดและทำงานแบบ AI Agent ได้ไกลขึ้น
จุดที่พัฒนาชัดที่สุดคืองานหลายขั้นตอนบนโค้ดเบสจริง เช่น ไล่แก้ระบบขนาดใหญ่จนผ่านชุดทดสอบทั้งหมด
บน Terminal-Bench 4.0 ที่วัดการทำงานผ่าน Command Line แบบอัตโนมัติ Claude Opus 5.5 ทำได้ 66.4% เทียบกับ 52.3% ของ Opus 5 และ 55.8% ของ Fable 5.1 ตัวอย่างจากผู้ทดสอบกลุ่มแรกที่ Anthropic เปิดเผย
- ย้ายโค้ด (Code Migration) 680,000 บรรทัดเสร็จในเวลาไม่ถึงหนึ่งวัน
- ตรวจและซ่อมโค้ดเบส 200,000 บรรทัดในเวลาไม่ถึง 3 ชั่วโมง ขณะที่ Opus 5 ใช้เวลากว่า 20 ชั่วโมง
- แปลง HAProxy จากภาษา C เป็น Rust ใน 9.5 ชั่วโมง เทียบกับ 12 ชั่วโมงของ Fable 5.1 และต้นทุนต่ำกว่าราว 51%
ด้านรีวิวโค้ด (Code Review) ก็จับบั๊กได้มากขึ้นโดยแจ้งเตือนผิด (False Positive) น้อยลง และอธิบายสิ่งที่แก้เป็นภาษาที่เข้าใจง่าย ทีมจึงตรวจทานงานของ AI ได้เร็วขึ้น ถ้าอยากเข้าใจว่า Agent ทำงานอย่างไร อ่านต่อได้ที่ AI Agent คืออะไร
2. งานวิเคราะห์และงานเอกสารแม่นยำขึ้น
สำหรับงานรายงาน วิเคราะห์ข้อมูล หรือโมเดลทางการเงิน Claude Opus 5.5 ได้คะแนน GDPval-AA v2.1 ที่ 1,846 Elo สูงกว่า Fable 5.1 (1,735) และ Opus 5 (1,708)
ที่สำคัญคือน่าเชื่อถือขึ้น Anthropic ระบุว่ามีโอกาสน้อยกว่า Opus 5 มากที่จะอ้างตัวเลขหรือแหล่งอ้างอิงที่ไม่มีในข้อมูลต้นทาง และจับจุดผิดปกติในเอกสารยาว ๆ ได้ดีขึ้น เช่น วันที่ที่ไม่ตรงกับวันในสัปดาห์ หรือกราฟในสไลด์ที่ไม่ตรงกับตัวเลข
3. อ่านกราฟ แผนภาพ และหน้าจอได้แม่นขึ้น
Claude Opus 5.5 อ่านค่าบนกราฟที่ข้อมูลหนาแน่น ความหมายของลูกศรในแผนภาพ และรายละเอียดจากภาพหน้าจอได้แม่นขึ้น บน Chartography ทำได้ 89.0% เทียบกับ 83.4% ของ Opus 5
Anthropic ระบุว่าแม้ตั้ง effort ต่ำสุด ก็อ่านกราฟได้แม่นกว่า Opus 5 ที่ตั้งค่าสูงสุด โดยใช้ token เพียงราวหนึ่งในสิบ งานควบคุมคอมพิวเตอร์ผ่านภาพหน้าจอ (Computer Use) ก็ทำสำเร็จได้เท่ากับ Opus 5 ที่ตั้งค่าสูงกว่ามาก โดยใช้ token น้อยลงราว 40%
4. สื่อสารชัดเจนและตรงประเด็นขึ้น
โมเดลใช้ศัพท์เทคนิคน้อยลงและขึ้นต้นด้วยข้อมูลสำคัญที่สุด เมื่อทำงานยาว ๆ ก็รายงานความคืบหน้าได้ตรงไปตรงมาว่าทำอะไรไปแล้ว พบอะไร และต้องการอะไรจากผู้ใช้
ผลทดสอบ Claude Opus 5.5 เทียบ Fable 5.1 และ Opus 5
ตัวเลขจากผลทดสอบที่ Anthropic ประกาศ (Claude Opus 5.5 ทดสอบที่ effort ระดับ max ยกเว้น Terminal-Bench 4.0 ที่ใช้ระดับ xhigh)
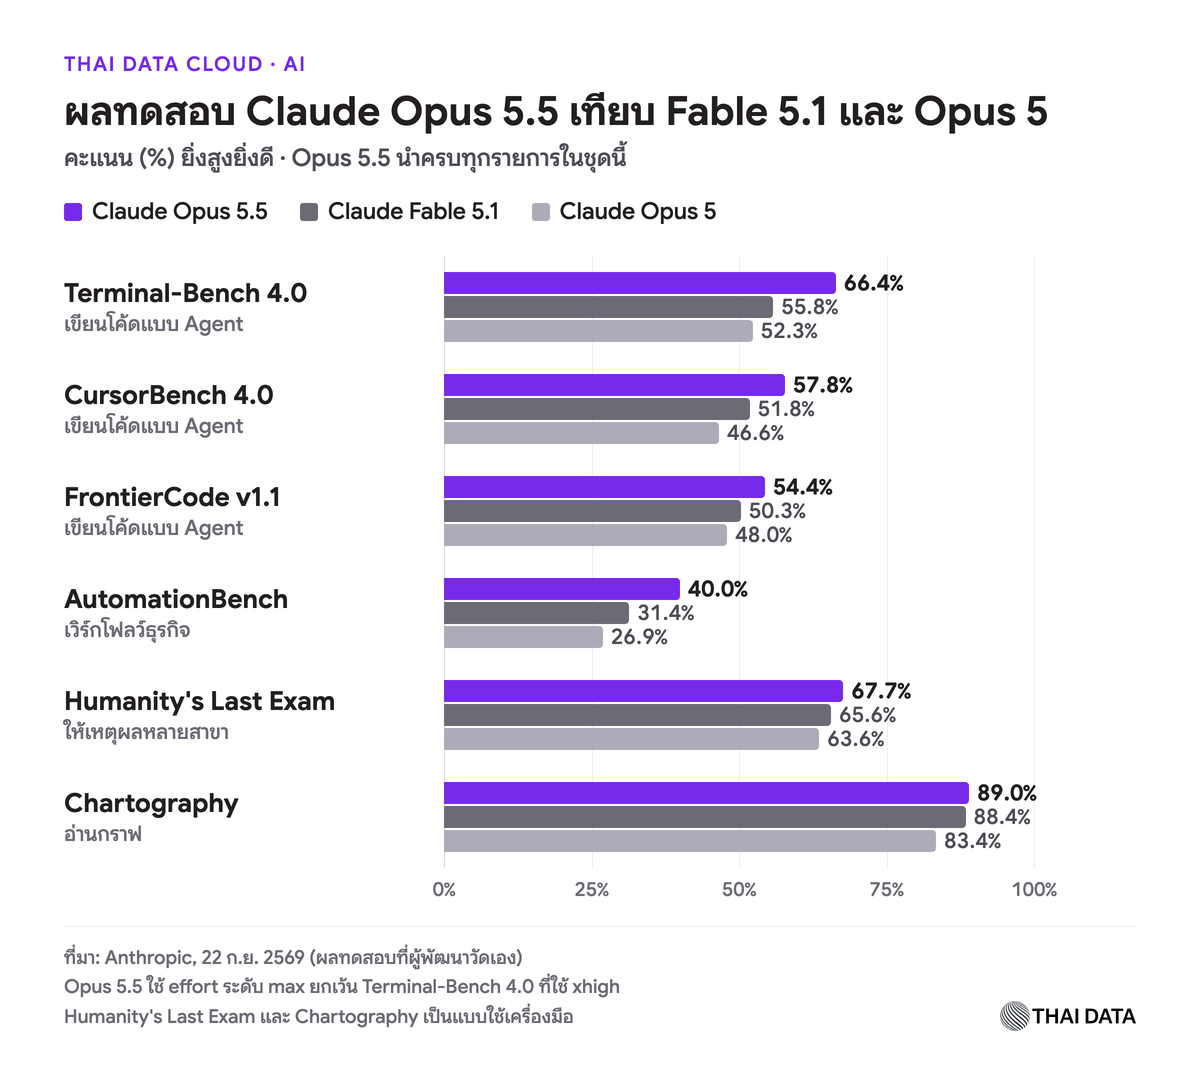
ตัวเลขเรียงตามลำดับ Opus 5.5 / Fable 5.1 / Opus 5
- Terminal-Bench 4.0 (เขียนโค้ดแบบ Agent): 66.4% / 55.8% / 52.3%
- CursorBench 4.0 (เขียนโค้ดแบบ Agent): 57.8% / 51.8% / 46.6%
- FrontierCode v1.1 (เขียนโค้ดแบบ Agent): 54.4% / 50.3% / 48.0%
- GDPval-AA v2.1 (งานเอกสารและงานวิเคราะห์): 1,846 / 1,735 / 1,708 Elo
- AutomationBench (เวิร์กโฟลว์ธุรกิจ): 40.0% / 31.4% / 26.9%
- Humanity's Last Exam (ให้เหตุผลหลายสาขา แบบใช้เครื่องมือ): 67.7% / 65.6% / 63.6%
- Chartography (อ่านกราฟ แบบใช้เครื่องมือ): 89.0% / 88.4% / 83.4%
เทียบกับค่ายอื่นในตารางเดียวกัน Claude Opus 5.5 นำ GPT-6 Astra ใน Terminal-Bench 4.0 (66.4% ต่อ 57.9%) และ GDPval-AA (1,846 ต่อ 1,542 Elo) แต่ยังตามหลังเล็กน้อยใน AutomationBench (40.0% ต่อ 41.4%) และ Terminal-Bench-Science (58.7% ต่อ 64.6%)
ทั้งหมดเป็นผลที่ Anthropic วัดเอง และ Anthropic ยอมรับว่าส่วนต่างคะแนนสะท้อนความต่างในงานจริงได้น้อยลง องค์กรจึงควรทดสอบกับงานของตัวเองก่อนตัดสินใจ
ราคา Claude Opus 5.5 ถูกลงแค่ไหน?
ราคาผ่าน API คิดต่อ 1 ล้าน token (token คือหน่วยนับข้อความที่ AI ประมวลผล)
- Input: $4 (Opus 5 อยู่ที่ $5)
- Output: $20 (Opus 5 อยู่ที่ $25)
- อ่านจาก Cache: $0.20 จากเดิม $0.50 ลดลง 60%
- เขียน Cache: $5 จากเดิม $6.25
- Fast Mode: $8 / $40 เร็วขึ้นสูงสุด 2.5 เท่า (รุ่นทดลอง ผ่าน Claude API และ Claude Code)
เมื่อเทียบกับ Fable 5.1 ที่ $10 / $50 แล้ว Claude Opus 5.5 ถูกกว่า 60% ต่อ token แต่ตัวเลขที่ควรดูมากกว่าคือต้นทุนต่องานที่ทำสำเร็จ ซึ่งลดลงอีกเพราะโมเดลใช้ token และขั้นตอนน้อยลง
ค่า Cache ที่ถูกลง 60% ยังช่วยให้งานที่ส่งเอกสารหรือคำสั่งชุดเดิมซ้ำ ๆ เช่น แชตบอตที่อ้างอิงคู่มือบริษัท ประหยัดได้มากขึ้นอีก
ใช้งาน Claude Opus 5.5 ได้ที่ไหนบ้าง
- แอป Claude บนเว็บ claude.ai เดสก์ท็อป และมือถือ โดยเพิ่มโควตาการใช้งานให้แพ็กเกจ Pro, Max, Team และ Enterprise
- Claude Code เครื่องมือเขียนโค้ดด้วย AI ในเทอร์มินัลและ IDE
- Claude API ด้วยชื่อโมเดล
claude-opus-5-5 - คลาวด์ชั้นนำ ได้แก่ Amazon Bedrock (AWS), Google Cloud และ Microsoft Foundry (Azure)