
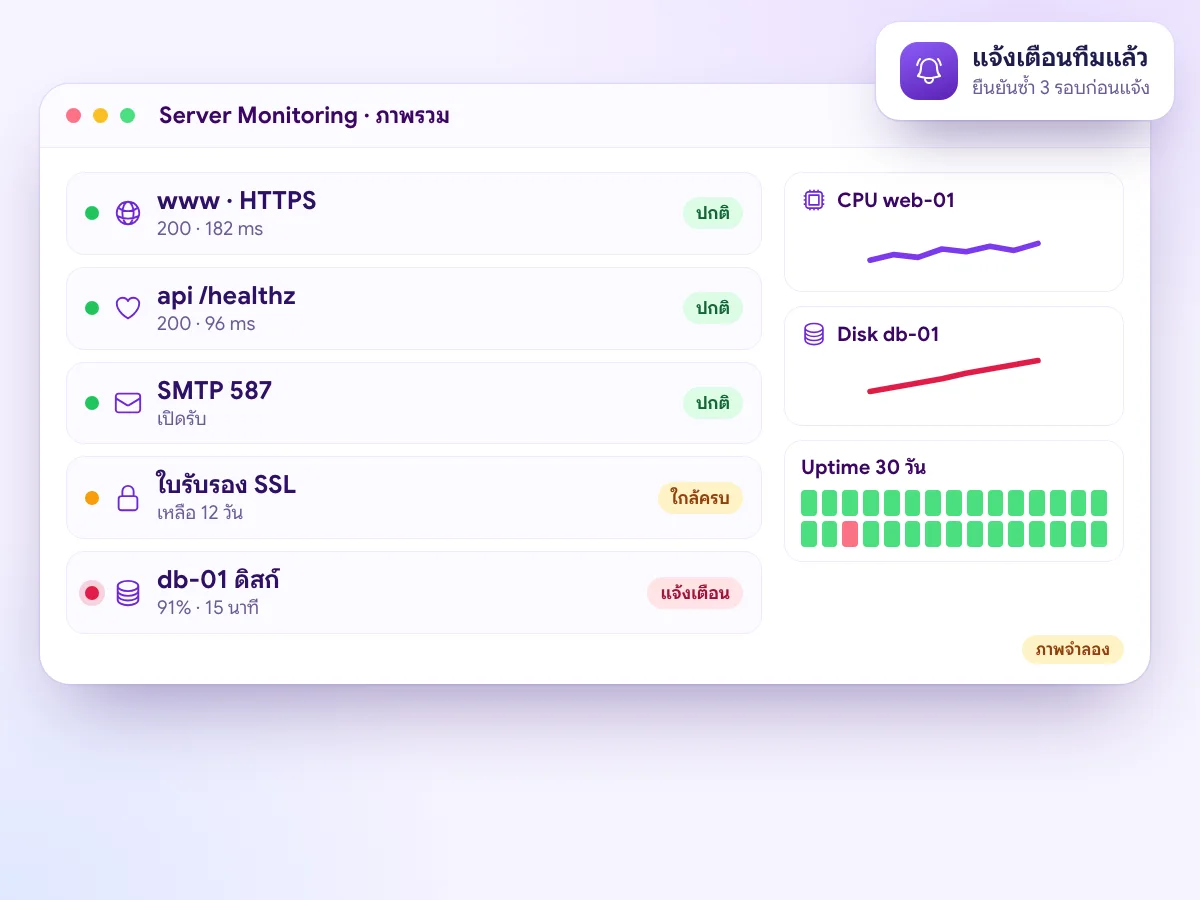
Monitoring & Alerts · เฝ้าระวังระบบและแจ้งเตือนServer Monitoring เฝ้าระวังเซิร์ฟเวอร์และเว็บไซต์ รู้ก่อนผู้ใช้เจอปัญหา
Server Monitoring จาก THAI DATA CLOUD มีให้เลือกสองระดับ ระดับแรกคุณตั้งเองได้บน TDC Enterprise ทั้งดูกราฟทรัพยากรของ Cloud Server และตั้ง Resource Health ให้ส่งอีเมลเตือนเมื่อค่าเกินเกณฑ์ ระดับที่สองให้ทีมวิศวกรของเราเฝ้าระวังเซิร์ฟเวอร์ เว็บไซต์ ฐานข้อมูล และงานสำรองข้อมูลตลอด 24 ชั่วโมง พร้อมรับมือเหตุและรายงานผลทุกเดือน
- ตั้ง Alert เองบน TDC Enterprise
- หรือให้ทีมเฝ้าระวัง 24/7
- ประเมินระบบฟรี
มาตรฐานที่ได้รับการรับรอง
- Data Center ในไทย TIA-942 Tier 3+
- Uptime SLA 99.9%
LINE ID @thaidatacloudแชทกับฝ่ายขาย
24x7x365 Online Supportดูแลทุกวันตลอด 24 ชม.

99.9%
Uptime เฉลี่ยตาม SLA
60 นาที
ตอบ Ticket เร็วสุด ระดับ Platinum
1,500 บาท
เริ่มต้นรับดูแลเซิร์ฟเวอร์ต่อเดือน
24x7x365
ทีมซัพพอร์ตและเฝ้าระวัง
คำตอบสั้น
Server Monitoring คืออะไร
Server Monitoring คือการเฝ้าดูเซิร์ฟเวอร์และบริการที่รันอยู่อย่างต่อเนื่อง ทั้ง CPU หน่วยความจำ ดิสก์ เครือข่าย บริการสำคัญ เว็บไซต์ และใบรับรอง SSL แล้วแจ้งเตือนผู้รับผิดชอบเมื่อค่าใดเกินเกณฑ์ที่ตั้งไว้ เพื่อให้แก้ไขได้ก่อนผู้ใช้เจอปัญหา และมีข้อมูลย้อนหลังไว้วางแผนขยายระบบ
ข้อมูลสำคัญ
- ดูกราฟ CPU, Memory, Network และ Disk ของ Cloud Server แต่ละเครื่องได้ในแท็บ Monitoring บน TDC Enterprise
- Resource Health ตั้ง Threshold รอบการตรวจ และรอบแจ้งซ้ำได้ราย Instance ค่าตั้งต้นส่งอีเมลเตือนถึงเจ้าของ Instance
- ทีม Managed Services ดูแล Server Monitoring ของเซิร์ฟเวอร์ เว็บไซต์ ฐานข้อมูล และงานสำรองข้อมูลตลอด 24 ชั่วโมง
- รับดูแลเซิร์ฟเวอร์เริ่มต้น 1,500 บาทต่อเดือน ราคาจริงตามขอบเขตงาน
- SLA Uptime เฉลี่ย 99.9% ตอบ Ticket ครั้งแรกภายใน 6 ชั่วโมงทำการ ถึง 60 นาทีตามระดับสมาชิก
Server Monitoring ของ THAI DATA CLOUD ช่วยอะไรได้บ้าง
ตั้งเองได้บนพอร์ทัล
ลูกค้า Cloud Server เปิด Resource Health ใน TDC Enterprise แล้วเลือก Metric เกณฑ์ และรอบแจ้งเตือนของแต่ละ Instance ได้เอง
ทีมเฝ้าระวัง 24/7
ทีมวิศวกรไทยรับ Alert ของ Server Monitoring นอกเวลาทำการ ตรวจสอบ และเริ่มแก้ตามขั้นตอนที่ตกลงไว้ องค์กรไม่ต้องจัดเวรเอง
ตรวจจากมุมผู้ใช้
Server Monitoring ตรวจเว็บไซต์ผ่าน HTTP/HTTPS พอร์ต ใบรับรอง SSL และ DNS จากภายนอก รู้ทันทีเมื่อผู้ใช้เข้าระบบไม่ได้
แจ้งเตือนเท่าที่จำเป็น
ตั้งเกณฑ์คู่กับระยะเวลายืนยัน ให้ Alert หนึ่งครั้งหมายถึงงานที่ต้องทำจริง ทีมจึงไม่ชินชากับเสียงเตือน
ครอบคลุมฐานข้อมูลและ Backup
เฝ้าการเชื่อมต่อฐานข้อมูล Query ที่ช้าลง และงานสำรองข้อมูลที่ไม่รันตามเวลา ไม่ใช่แค่กราฟ CPU กับ RAM
รายงานทุกเดือน
สรุป Uptime เหตุขัดข้อง แนวโน้มทรัพยากร และสิ่งที่ควรขยายหรือแก้ ผู้บริหารเห็นภาพเดียวกับทีมเทคนิค
Server Monitoring ต้องเฝ้าดูอะไรบ้าง ตั้งแต่ทรัพยากรถึงใบรับรอง
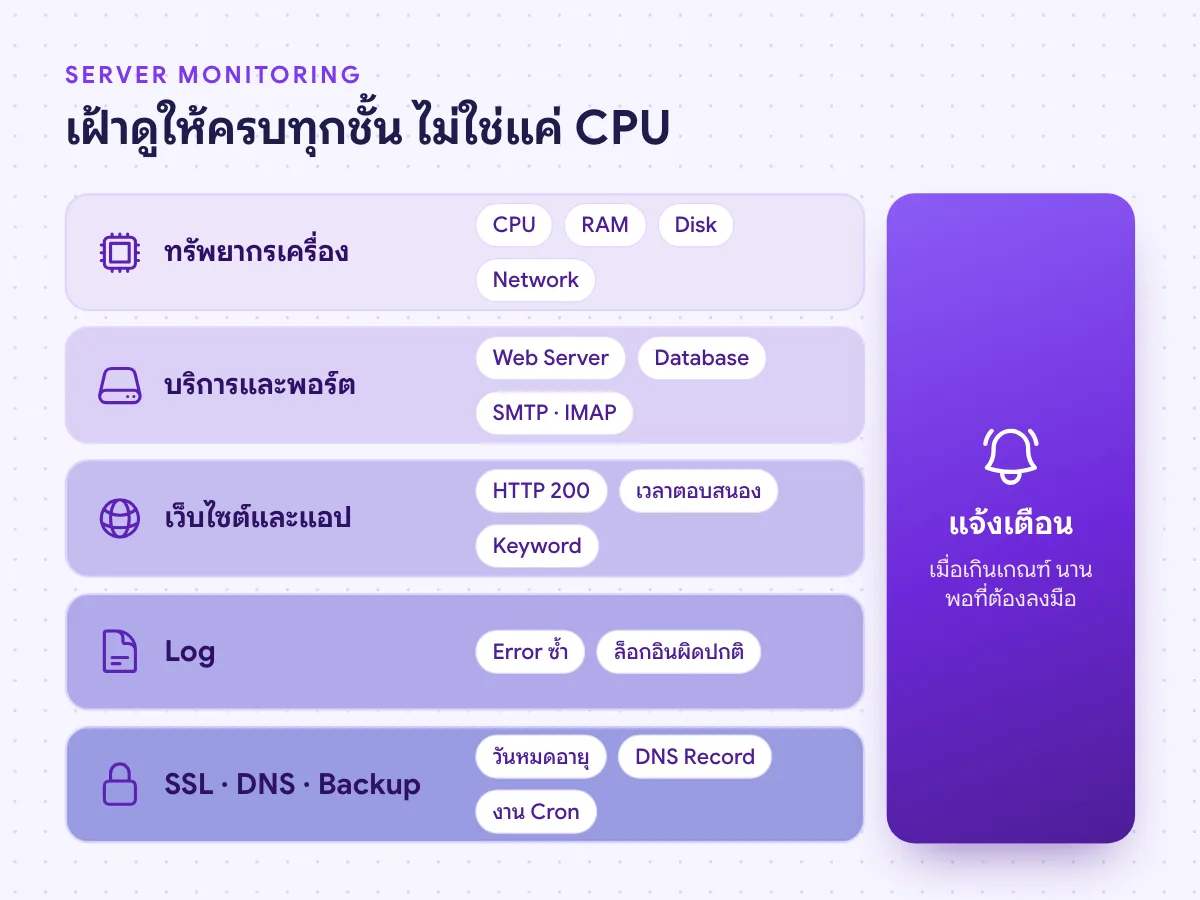
เซิร์ฟเวอร์ที่ CPU ยังต่ำอาจให้บริการไม่ได้แล้วก็ได้ เช่น Web Server หยุดทำงาน ใบรับรอง SSL หมดอายุ หรือดิสก์เต็มจนฐานข้อมูลเขียนต่อไม่ได้ Server Monitoring ที่ใช้งานได้จริงจึงต้องดูหลายชั้นพร้อมกัน ไม่ใช่แค่กราฟทรัพยากร
หลักง่าย ๆ คือเฝ้าทั้งสาเหตุและอาการ ทรัพยากรเครื่องบอกสาเหตุล่วงหน้า เช่น ดิสก์ใกล้เต็ม ส่วนการตรวจจากมุมผู้ใช้บอกอาการที่เกิดขึ้นแล้ว เช่น หน้าเว็บตอบช้าหรือขึ้น Error 502 ระบบที่ดีต้องมีทั้งสองแบบคู่กัน
- ทรัพยากรเครื่อง: CPU, RAM, พื้นที่ดิสก์, Disk I/O, ทราฟฟิกเครือข่าย และ Load Average
- บริการและพอร์ต: Web Server, ฐานข้อมูล, SMTP/IMAP และ Process สำคัญยังทำงานอยู่หรือไม่
- เว็บไซต์และแอป: รหัสตอบกลับ HTTP เวลาตอบสนอง และคำที่ต้องมีบนหน้าเว็บ
- Log: Error ที่เกิดซ้ำ การล็อกอินผิดปกติ และ Service ที่รีสตาร์ตเอง
- ใบรับรองและ DNS: วันหมดอายุ SSL วันหมดอายุโดเมน และ Record ที่ชี้ไป IP ถูกต้อง
- งานตั้งเวลา: Backup และ Cron ที่ต้องรันตามรอบ ถ้าไม่รันต้องมีคนรู้
ตั้ง Server Monitoring เองบน TDC Enterprise ด้วยกราฟ Monitoring และ Resource Health
ลูกค้า Cloud Server ของ THAI DATA CLOUD มีเครื่องมือพื้นฐานอยู่ใน TDC Enterprise แล้วสองส่วน ส่วนแรกคือแท็บ Monitoring ในหน้าเซิร์ฟเวอร์แต่ละเครื่อง แสดงกราฟ CPU Usage, Memory Usage, Network และ Disk ย้อนหลังตามช่วงเวลาที่เลือก ดูได้ทั้งค่า Max และ Average ส่วน GPU Server มีกราฟการใช้ GPU เพิ่มเข้ามา
ส่วนที่สองคือ Resource Health ในเมนู Monitoring เมื่อเปิดใช้งานแล้ว คุณสร้าง Instance Monitor ให้แต่ละเครื่องได้ เลือก Metric กฎการเปรียบเทียบ และค่า Threshold แล้วกำหนดว่าระบบจะตรวจถี่แค่ไหน (Duration) และถ้าปัญหาเดิมยังอยู่จะแจ้งซ้ำเมื่อใด (Period) Alert Setting แบบตั้งต้นส่งอีเมลเตือนไปยังเจ้าของ Instance
เครื่องมือชุดนี้เหมาะกับการรู้ทันเมื่อทรัพยากรของเครื่องเกินเกณฑ์ ส่วนการตรวจเว็บไซต์จากภายนอก ใบรับรอง ฐานข้อมูล และการรับมือเหตุนอกเวลา เป็นงานของ Server Monitoring ระดับ Managed ในหัวข้อถัดไป
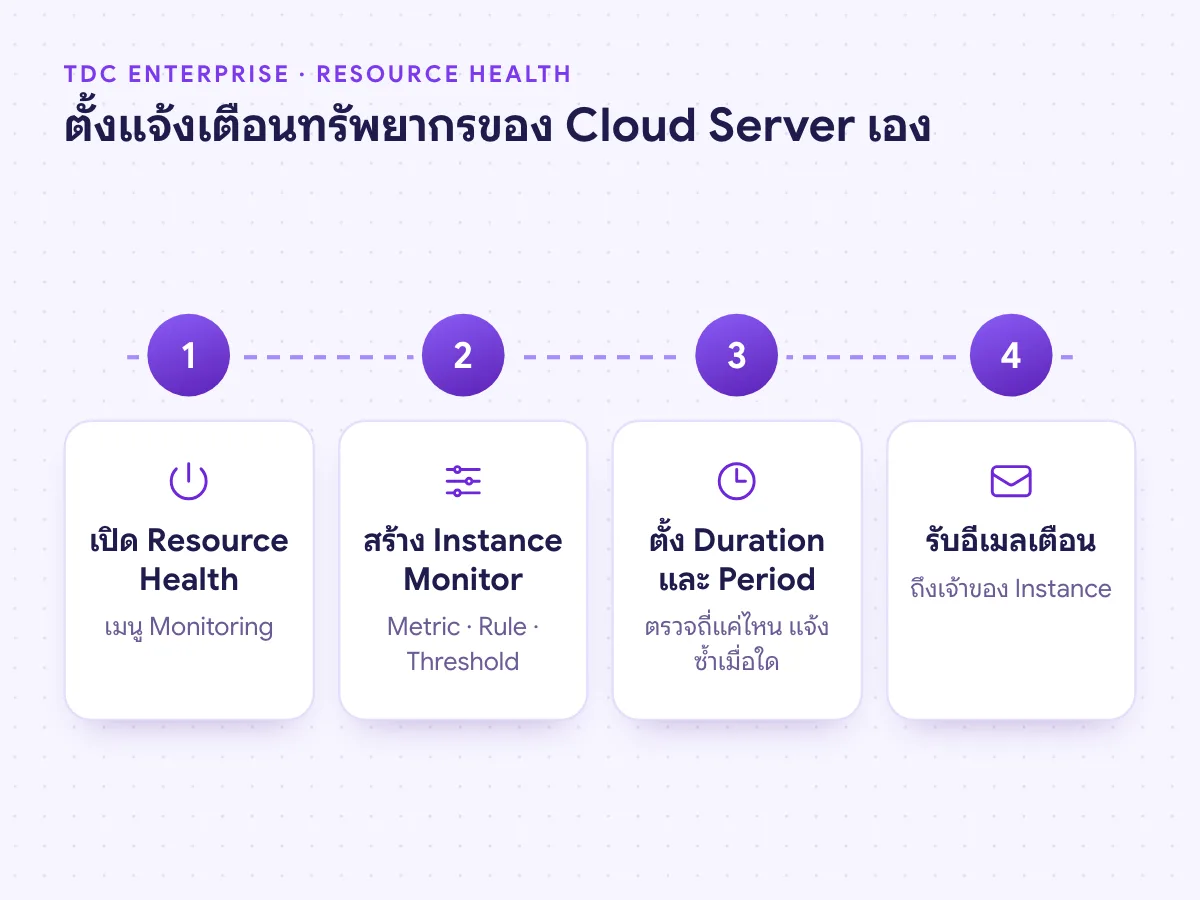
| ช่องที่ตั้งค่าใน Resource Health | ความหมาย |
|---|---|
| Metric Type | ค่าของ Instance ที่ต้องการเฝ้าดู |
| Rule และ Threshold | เงื่อนไขและเกณฑ์ที่ถือว่าผิดปกติ เช่น สูงกว่ากี่เปอร์เซ็นต์ |
| Duration | ความถี่ที่ระบบตรวจค่าของเครื่อง |
| Period | ระยะรอก่อนแจ้งซ้ำเมื่อพบปัญหาเดิมอีก หรือเลือกให้แจ้งทุกครั้ง |
| Alert Group | กลุ่มการแจ้งเตือน ค่าตั้งต้นส่งอีเมลถึงเจ้าของ Instance |
| Active / Inactive | เปิดหรือพักการตรวจของ Monitor นั้นได้โดยไม่ต้องลบ |
ให้ทีม Managed Services ดูแล Server Monitoring ต่างจากตั้งเองอย่างไร
การตั้งแจ้งเตือนเองเหมาะกับทีมที่มีคนพร้อมรับอีเมลและเข้าไปแก้เครื่องได้ทุกเวลา แต่ในหลายองค์กร อีเมลแจ้งเตือนตอนตีสองถูกอ่านตอนเก้าโมงเช้า ระบบล่มไปหลายชั่วโมงแล้ว
ในบริการ Managed Services ทีมวิศวกรของเราออกแบบชุดการตรวจ Server Monitoring ให้ตรงกับระบบของคุณ เฝ้าระวังตลอด 24 ชั่วโมง ส่งการแจ้งเตือนถึงคนที่ต้องลงมือ และยกระดับเหตุตามขั้นตอนที่ตกลงไว้ ทีมเดียวกันนี้ดูแลเซิร์ฟเวอร์อยู่แล้ว เมื่อมีการแจ้งเตือนจึงเข้าแก้ได้ตามขอบเขตงาน ไม่ต้องส่งต่อหลายทอด
งานรับดูแลเซิร์ฟเวอร์เริ่มต้น 1,500 บาทต่อเดือน ขอบเขตการเฝ้าระวังและราคาจริงประเมินหลังดูระบบ
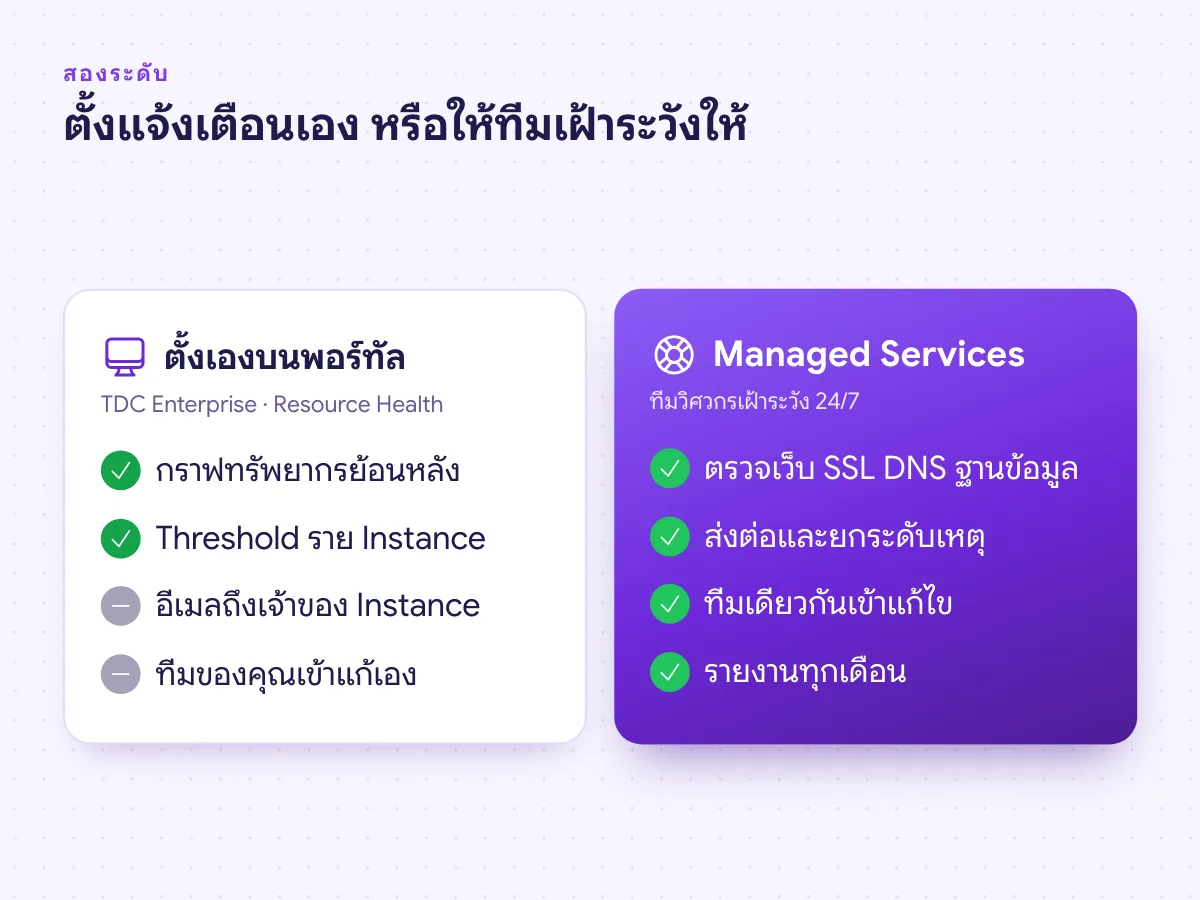
| ประเด็น | ตั้งเองบน TDC Enterprise | Managed Services |
|---|---|---|
| สิ่งที่ตรวจ | ทรัพยากรของ Cloud Instance | เซิร์ฟเวอร์ เว็บไซต์ พอร์ต SSL DNS ฐานข้อมูล และ Backup |
| เซิร์ฟเวอร์ที่รองรับ | Cloud Server บน THAI DATA CLOUD | คลาวด์ของเรา On-Premise, Co-location และคลาวด์รายอื่น |
| ใครรับการแจ้งเตือน | อีเมลถึงเจ้าของ Instance | ทีมวิศวกร 24/7 แล้วแจ้งผู้ติดต่อฝั่งคุณ |
| เมื่อเกิดเหตุ | ทีมของคุณเข้าแก้เอง | ทีมเราตรวจสอบและแก้ตามขอบเขตงานและ SLA |
| รายงาน | กราฟย้อนหลังในพอร์ทัล | รายงานสรุปรายเดือน |
ตรวจ Uptime เว็บไซต์จากภายนอก: HTTP, HTTPS, พอร์ต, SSL และ DNS
เซิร์ฟเวอร์ที่ทำงานปกติจากข้างในอาจให้บริการคนข้างนอกไม่ได้ เช่น DNS ชี้ผิด Firewall ปิดพอร์ต หรือใบรับรองหมดอายุจนเบราว์เซอร์ขึ้นคำเตือน การตรวจ Uptime จึงต้องยิงจากเครื่องที่อยู่คนละที่กับระบบที่ถูกตรวจ ถ้าวางตัวตรวจไว้บนเครื่องเดียวกัน เมื่อเครื่องล่ม ตัวตรวจก็ล่มไปด้วย
การตรวจแบบ Keyword ช่วยจับหน้าเว็บที่ตอบรหัส 200 แต่แสดงข้อความ Error ส่วนแอปที่มีฐานข้อมูลควรมี URL สำหรับตรวจสุขภาพ เช่น /healthz ที่ทดสอบการเชื่อมต่อฐานข้อมูลด้วย และตอบ 503 เมื่อมีปัญหา
ใบรับรอง SSL กำลังมีอายุสั้นลง CA/Browser Forum ลงมติให้ลดอายุสูงสุดของใบรับรอง TLS สาธารณะจาก 398 วันลงเป็นลำดับ เริ่มมีนาคม 2026 จนเหลือ 47 วันในมีนาคม 2029 การต่ออายุจะถี่ขึ้นมาก การเตือนล่วงหน้าก่อนหมดอายุจึงเป็นส่วนจำเป็นของ Server Monitoring
อีกส่วนที่ช่วยได้มากคือหน้าสถานะสาธารณะ (Status Page) ซึ่งบอกลูกค้าว่าระบบเป็นอย่างไรโดยไม่ต้องโทรถาม THAI DATA CLOUD ใช้หน้าแบบนี้เองที่ uptime.thaidata.cloud สร้างด้วย Uptime Kuma แสดงสถานะแยกตามกลุ่มบริการ เช่น Cloud Instance แต่ละโซน Cloud Private Mail, Cloud Domain และ SSL Certificate Service
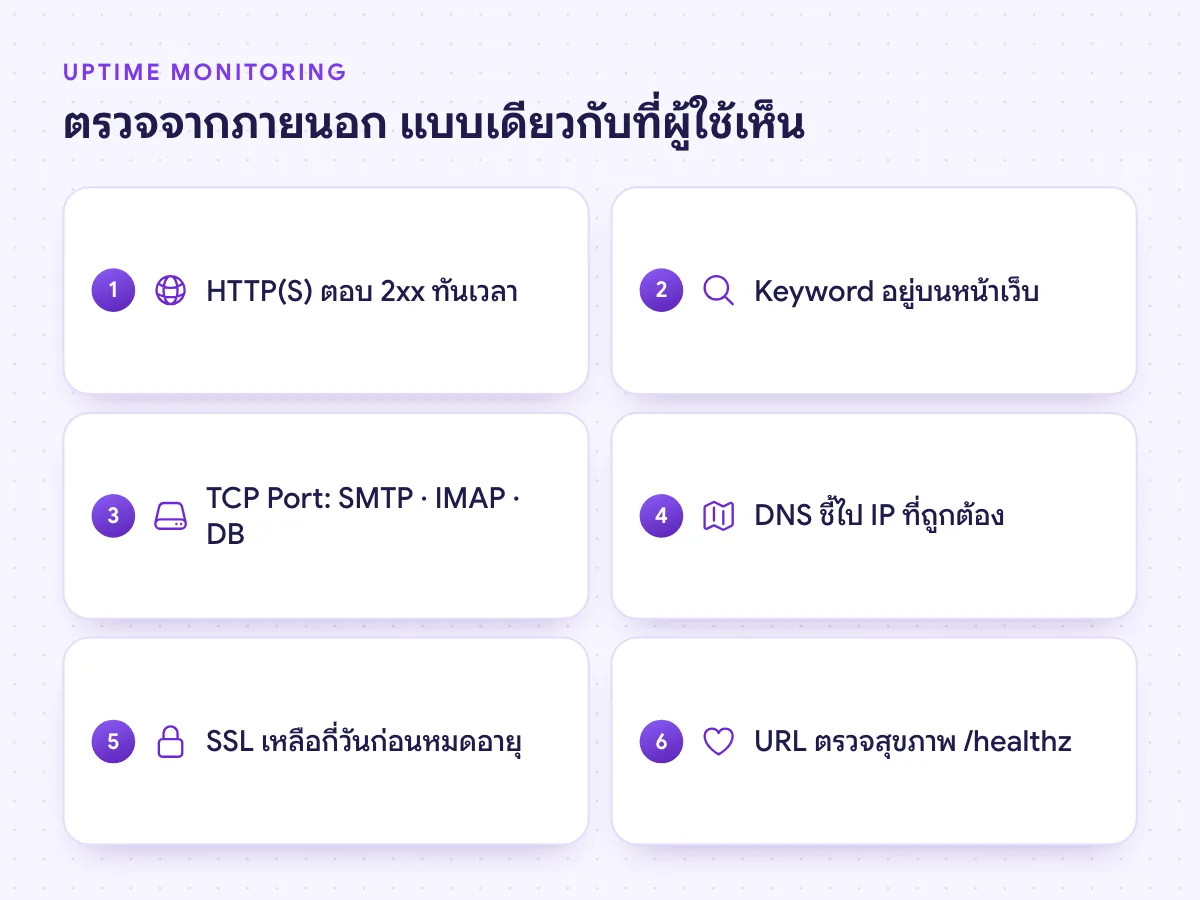
| ชนิดการตรวจ | ตรวจอะไร | ใช้เมื่อ |
|---|---|---|
| HTTP(S) | ได้รหัส 2xx ภายในเวลาที่กำหนด | ทุกเว็บไซต์และ API |
| HTTP(S) + Keyword | หน้าเว็บมีคำที่กำหนดอยู่จริง | เว็บที่อาจตอบ 200 แต่แสดงหน้า Error |
| TCP Port | พอร์ตเปิดรับการเชื่อมต่อ | SMTP 587, IMAP 993 และฐานข้อมูล |
| DNS Record | โดเมนยังชี้ไป IP ที่ถูกต้อง | กันโดเมนหมดอายุหรือ Record ถูกแก้ |
| วันหมดอายุ SSL | ใบรับรองเหลือกี่วัน | ทุกเว็บที่ใช้ HTTPS |
| Ping (ICMP) | เครื่องตอบในระดับเครือข่าย | ใช้ประกอบเท่านั้น เพราะเครื่องตอบ Ping ได้ขณะที่เว็บล่ม |
ตั้ง Alert อย่างไรไม่ให้ทีมจมการแจ้งเตือน (Alert Fatigue)
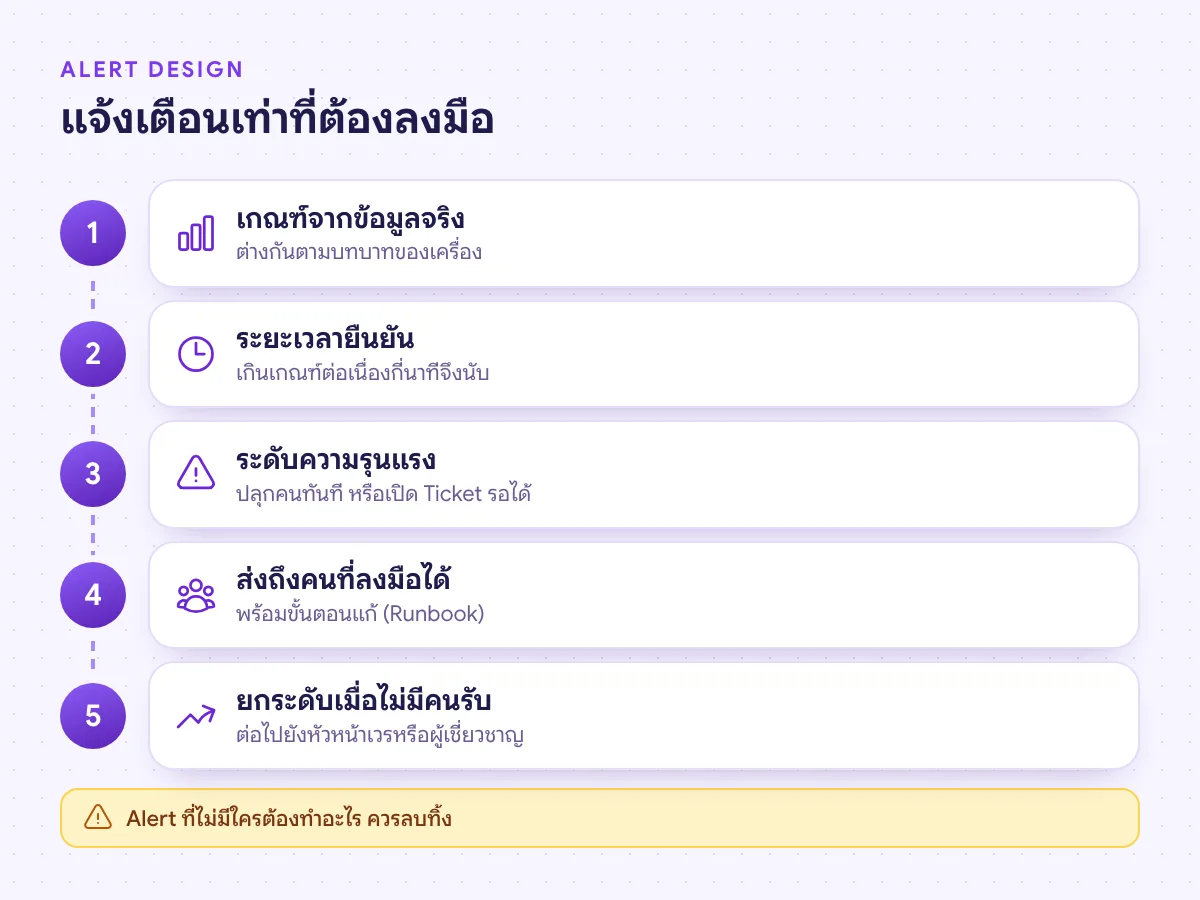
Server Monitoring ที่แจ้งเตือนวันละหลายสิบครั้งจะสอนให้ทีมเลิกอ่าน แล้ววันที่เหตุจริงเกิด Alert สำคัญจะจมอยู่ในกองนั้น แนวปฏิบัติของ Prometheus ซึ่งสรุปจากประสบการณ์ของวิศวกร Google บอกไว้สั้น ๆ ว่า ให้ Alert เรียบง่าย แจ้งเตือนที่อาการซึ่งผู้ใช้รู้สึก และอย่าส่ง Alert ที่ไม่มีอะไรให้ทำ
เกณฑ์ตัวเลขอย่างเดียวไม่พอ ต้องมีระยะเวลายืนยันด้วย CPU แตะ 95% ไม่กี่วินาทีระหว่าง Backup เป็นเรื่องปกติ แต่ค้างที่ 95% สิบห้านาทีคือปัญหา ใน Resource Health ของ TDC Enterprise ช่อง Period ทำหน้าที่คุมการแจ้งซ้ำ ไม่ให้ปัญหาเดิมส่งอีเมลรัว
- แยกระดับความรุนแรง: เหตุที่ผู้ใช้กระทบอยู่ต้องปลุกคน เรื่องที่รอได้ส่งเป็น Ticket หรือรายงาน
- ตั้งเกณฑ์จากข้อมูลจริงหลายสัปดาห์ ไม่ใช่ตัวเลขเดียวกันทุกเครื่อง
- ยืนยันซ้ำ 2-3 รอบก่อนประกาศว่าล่ม ลดเหตุเตือนผิดจากเครือข่ายสะดุดครั้งเดียว
- ทุก Alert มีเจ้าของและขั้นตอนแก้ (Runbook) ถ้าไม่มีใครต้องทำอะไร ให้ลบทิ้ง
- แจ้งเมื่อกลับมาปกติ และตั้งช่วงปิดปรับปรุง (Maintenance Window) ล่วงหน้า
- ทบทวน Alert ที่ดังบ่อยทุกเดือน แล้วแก้ที่ต้นเหตุหรือปรับเกณฑ์
Uptime 99.9% ล่มได้กี่นาที คำนวณจากผล Server Monitoring อย่างไร
Uptime คือสัดส่วนเวลาที่ระบบใช้งานได้ต่อเวลาทั้งหมด เดือนที่มี 30 วันมี 43,200 นาที Uptime 99.9% จึงหมายถึงหยุดได้ไม่เกินราว 43.2 นาทีต่อเดือน ส่วน 99.99% เหลือเพียงราว 4.3 นาที ตัวเลขที่ดูต่างกันนิดเดียวจึงต่างกันสิบเท่าในทางปฏิบัติ
ระบบที่ต่อกันเป็นทอดต้องคูณ Uptime เข้าหากัน เว็บที่ต้องพึ่งทั้ง Web Server และฐานข้อมูลซึ่งได้ 99.9% ทั้งคู่ จะเหลือราว 99.8% หรือหยุดได้ราว 86 นาทีต่อเดือน นี่คือเหตุผลที่ระบบสำคัญต้องมีเครื่องสำรอง และต้องเฝ้าทุกทอด
ความถี่ในการตรวจมีผลกับตัวเลขที่วัดได้ ถ้าตรวจทุก 5 นาที เหตุที่ล่ม 3 นาทีอาจไม่ถูกบันทึกเลย ระบบที่ตั้งเป้า Uptime สูงจึงต้องตรวจถี่ขึ้นตาม SLA ของ THAI DATA CLOUD รับประกัน Uptime เฉลี่ย 99.9% ดูเงื่อนไขทั้งหมดได้ที่หน้า SLA
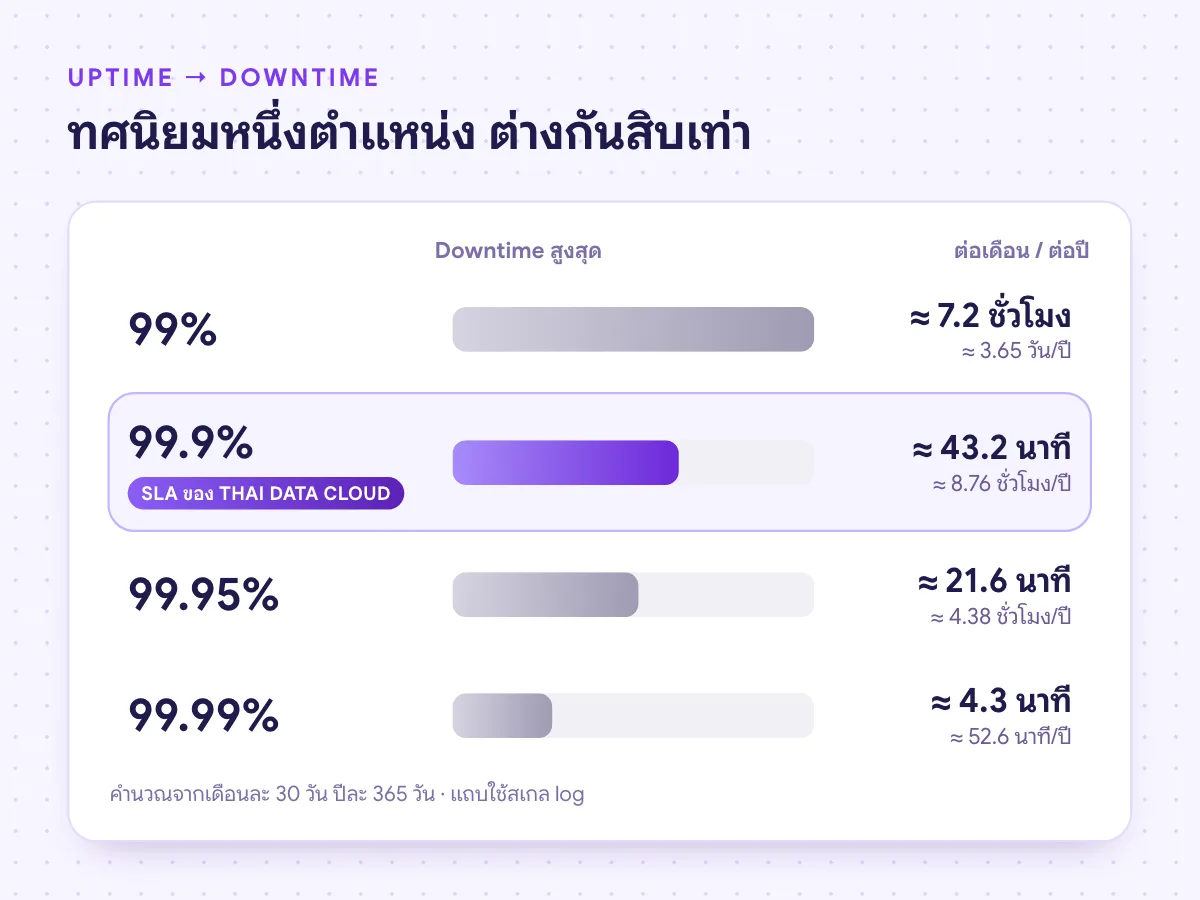
| Uptime | หยุดได้ต่อเดือน (30 วัน) | หยุดได้ต่อปี (365 วัน) |
|---|---|---|
| 99% | ประมาณ 7.2 ชั่วโมง | ประมาณ 3.65 วัน |
| 99.9% | ประมาณ 43.2 นาที | ประมาณ 8.76 ชั่วโมง |
| 99.95% | ประมาณ 21.6 นาที | ประมาณ 4.38 ชั่วโมง |
| 99.99% | ประมาณ 4.3 นาที | ประมาณ 52.6 นาที |
เครื่องมือ Server Monitoring: Zabbix, Prometheus กับ Grafana, Uptime Kuma และ Netdata
ไม่มีเครื่องมือ Server Monitoring ตัวเดียวที่เหมาะกับทุกระบบ ทีมของเราทำงานกับเครื่องมือโอเพนซอร์สที่ใช้กันแพร่หลาย และเลือกตามขนาดระบบ ทีมที่จะดูแลต่อ และเครื่องมือที่องค์กรมีอยู่แล้ว ถ้าคุณใช้ระบบเฝ้าระวังเดิมอยู่ เราเข้าไปดูแลต่อบนระบบนั้นได้
องค์กรที่อยากลงมือเอง อ่านคู่มือติดตั้งแต่ละตัวบนเว็บไซต์นี้ได้ ทุกตัวรันบน Cloud Server ในประเทศไทย ข้อมูลการเฝ้าระวังจึงอยู่ในระบบที่องค์กรควบคุมเอง
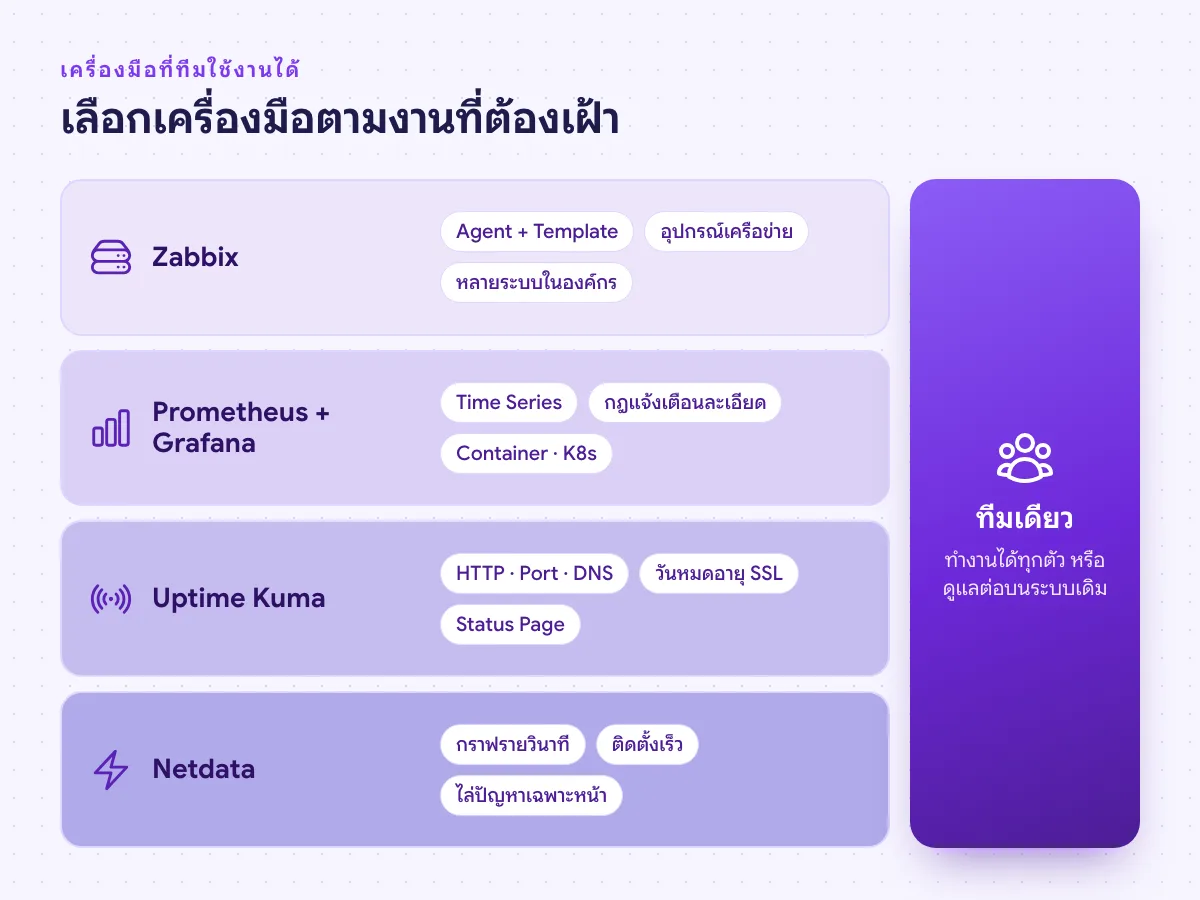
| เครื่องมือ | เด่นเรื่อง | เหมาะกับ |
|---|---|---|
| Zabbix | Agent บนเครื่อง Template สำเร็จรูป และตรวจอุปกรณ์เครือข่ายได้ | องค์กรที่มีเซิร์ฟเวอร์และอุปกรณ์หลายชนิด |
| Prometheus + Grafana | เก็บ Metric แบบ Time Series เขียนกฎแจ้งเตือนได้ละเอียด และทำ Dashboard | ระบบ Container, Kubernetes และทีมที่เขียนกฎเองได้ |
| Uptime Kuma | ตรวจเว็บ พอร์ต DNS และ SSL จากภายนอก พร้อมหน้าสถานะ | ตรวจ Uptime เว็บไซต์และบริการ |
| Netdata | กราฟละเอียดรายวินาที ติดตั้งเร็ว | ไล่ปัญหาเฉพาะหน้าบนเครื่องที่กำลังช้า |
| Healthchecks | เตือนเมื่องาน Cron หรือ Backup ไม่รันตามเวลา | งานตั้งเวลาที่เงียบเมื่อพัง |
| Performance Monitor | ตัวนับประสิทธิภาพของ Windows Server | ไล่คอขวดบน Windows |
Zabbix ด้วย Docker Compose
ติดตั้ง Zabbix 7.0 LTS ครบทั้ง Server หน้าเว็บ และ Agent แล้วเพิ่มเครื่องแรก
อ่านคู่มือPrometheus กับ Grafana Dashboard
ต่อ Grafana กับ Prometheus นำเข้า Dashboard สำเร็จรูป และตั้งการแจ้งเตือน
อ่านคู่มือNode Exporter
เก็บเมตริกเซิร์ฟเวอร์ให้ Prometheus และเขียนกฎแจ้งเตือนพื้นฐาน
อ่านคู่มือNetdata แบบเรียลไทม์
ดูกราฟ CPU ดิสก์ เครือข่าย และฐานข้อมูลรายวินาที พร้อมปิดหน้าเว็บจากภายนอก
อ่านคู่มือHealthchecks สำหรับ Cron
เตือนทันทีเมื่องาน Backup ไม่ทำงานตามเวลา
อ่านคู่มือPerformance Monitor บน Windows
ตั้ง Data Collector Set แล้วอ่านตัวนับที่บอกคอขวดจริง
อ่านคู่มือเฝ้าฐานข้อมูล Log และงานสำรองข้อมูล ส่วนที่มักถูกลืมใน Server Monitoring
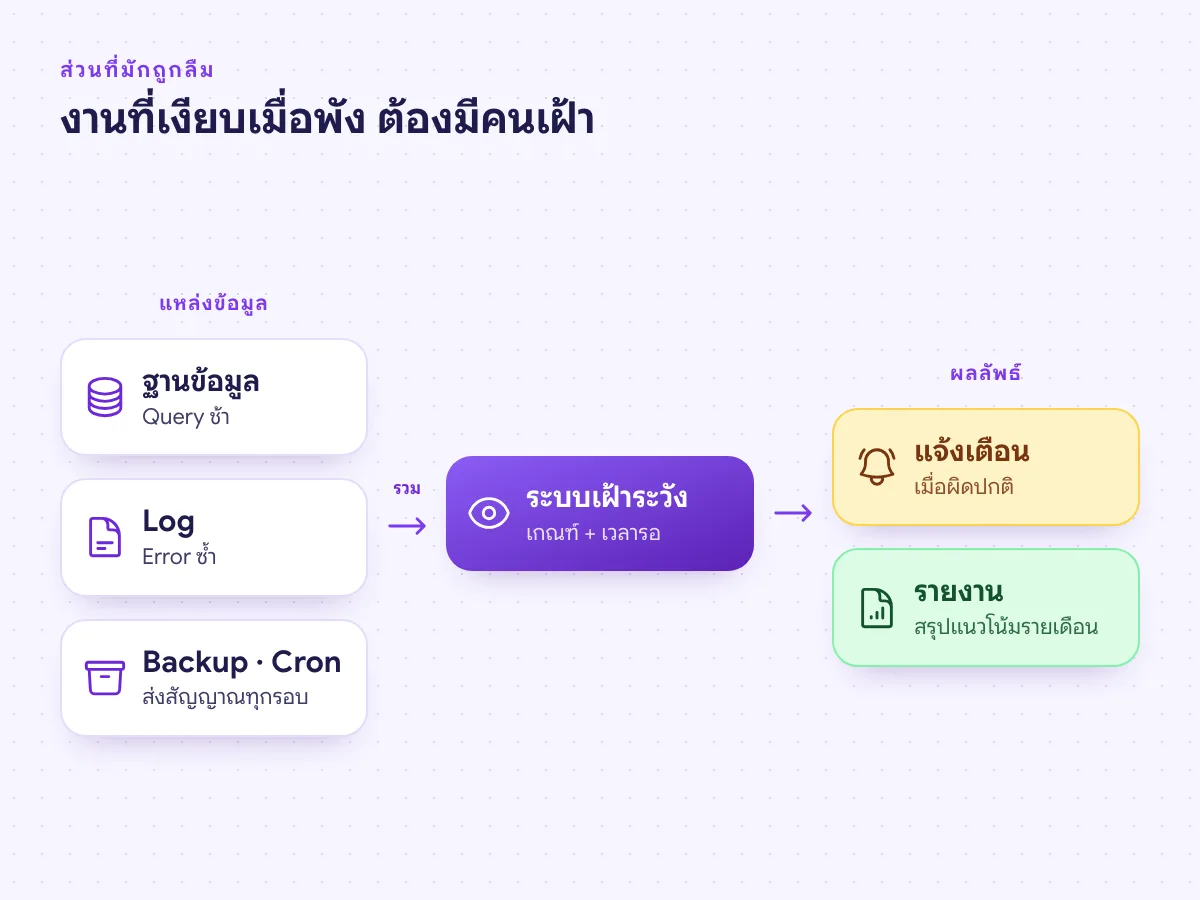
ปัญหาใหญ่หลายครั้งเริ่มจากส่วนที่ไม่มีใครเฝ้า Backup ที่หยุดรันไปหลายเดือนโดยไม่มีใครรู้มักถูกค้นพบในวันที่ต้องกู้ข้อมูล งานตั้งเวลาเหล่านี้ไม่ส่งเสียงเมื่อพัง จึงต้องเฝ้าแบบ Dead man's switch คือให้งานส่งสัญญาณทุกครั้งที่รันเสร็จ ถ้าสัญญาณหายไปเกินเวลาที่กำหนด ระบบจะแจ้งเตือน
Server Monitoring ของฐานข้อมูลต้องดูมากกว่า CPU ของเครื่อง เช่น จำนวนการเชื่อมต่อที่ใกล้เพดาน Query ที่ช้าลง Replication ที่ล้าหลัง และพื้นที่ที่โตเร็วผิดปกติ ส่วน Log ควรรวมไว้ที่เครื่องกลาง เพื่อค้นย้อนหลังได้แม้เครื่องต้นทางเสีย และเห็นรูปแบบ Error ที่เกิดซ้ำ
ฝั่ง THAI DATA CLOUD เองเก็บ Log 90 วันตาม พ.ร.บ.คอมพิวเตอร์ ตามที่ระบุใน SLA ส่วนการเก็บและวิเคราะห์ Log ของระบบลูกค้าออกแบบตามขอบเขตงาน
- Backup และ Cron: แจ้งเตือนเมื่องานไม่รันตามเวลา หรือรันแล้วล้มเหลว
- ฐานข้อมูล: การเชื่อมต่อ Query ช้า Replication Lag และพื้นที่ที่เหลือ
- Log: Error ที่เกิดซ้ำ ล็อกอินผิดปกติ และ Service ที่รีสตาร์ตเอง
MySQL Slow Query Log
เปิด Slow Query Log แล้วหา Query ที่ทำให้เว็บช้าด้วย mysqldumpslow และ EXPLAIN
อ่านคู่มือรวม Log ด้วย rsyslog
ตั้งเซิร์ฟเวอร์กลางรับ Log จากหลายเครื่อง และเข้ารหัสการส่งด้วย TLS
อ่านคู่มืออ่าน Log ด้วย journalctl
ดู Log ของ Service ตามช่วงเวลา ระดับความรุนแรง และรอบการบูต
อ่านคู่มือรายงาน Server Monitoring รายเดือนช่วยวางแผนระบบอย่างไร
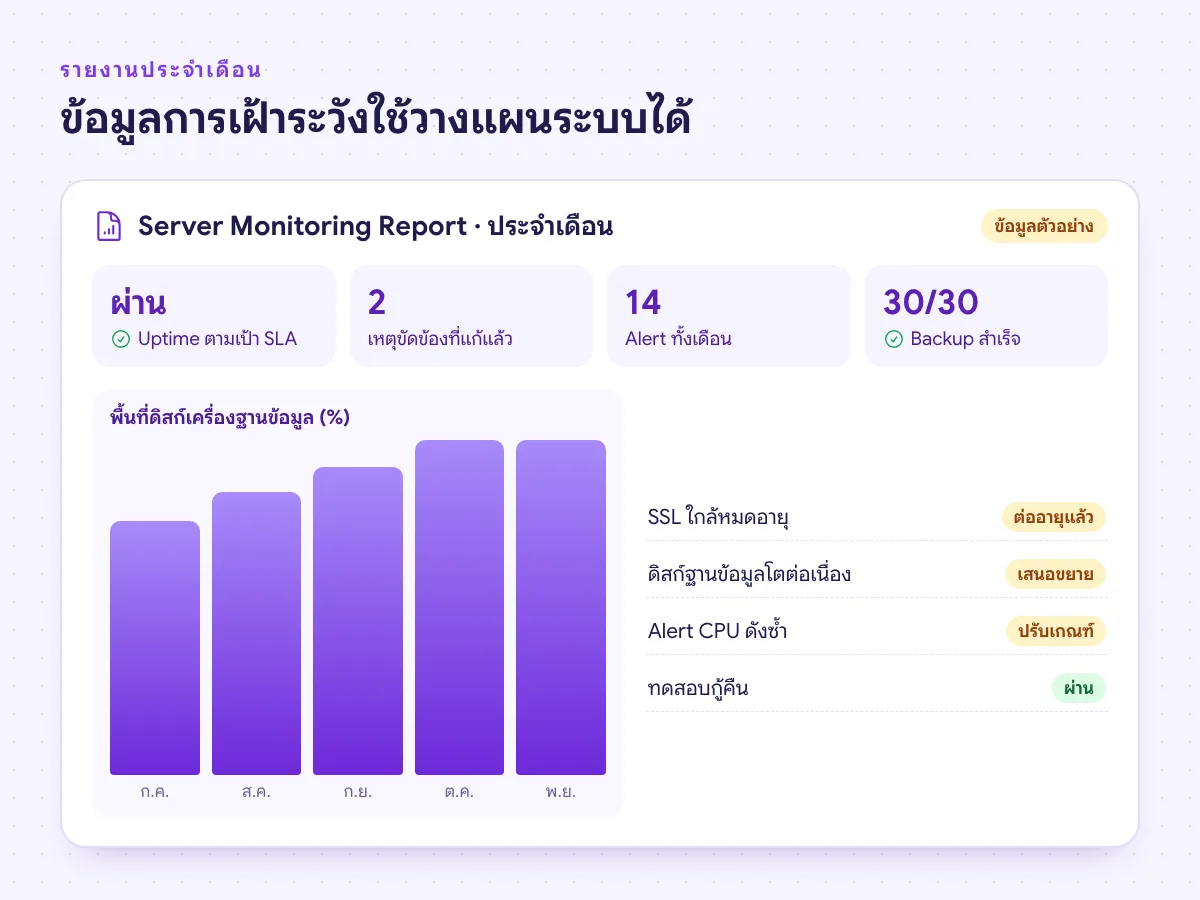
ข้อมูลจากการเฝ้าระวังมีค่ามากกว่าการแจ้งเตือนตอนเกิดเหตุ เมื่อรวมเป็นรายเดือนจะเห็นแนวโน้มที่มองไม่เห็นในแต่ละวัน เช่น ดิสก์ที่โตขึ้นทุกเดือนจะเต็มเมื่อไร หรือเครื่องไหนว่างเกือบตลอดจนควรลดสเปก
ในบริการ Managed Services รายงาน Server Monitoring รายเดือนสรุปความพร้อมใช้ของระบบเทียบเป้าหมาย เหตุขัดข้องพร้อมสาเหตุและสิ่งที่แก้ Alert ที่ดังบ่อย ใบรับรองและโดเมนที่ใกล้หมดอายุ และคำแนะนำสำหรับเดือนถัดไป
Server Monitoring กับ APM ต่างกันอย่างไร ควรเริ่มจากอะไร
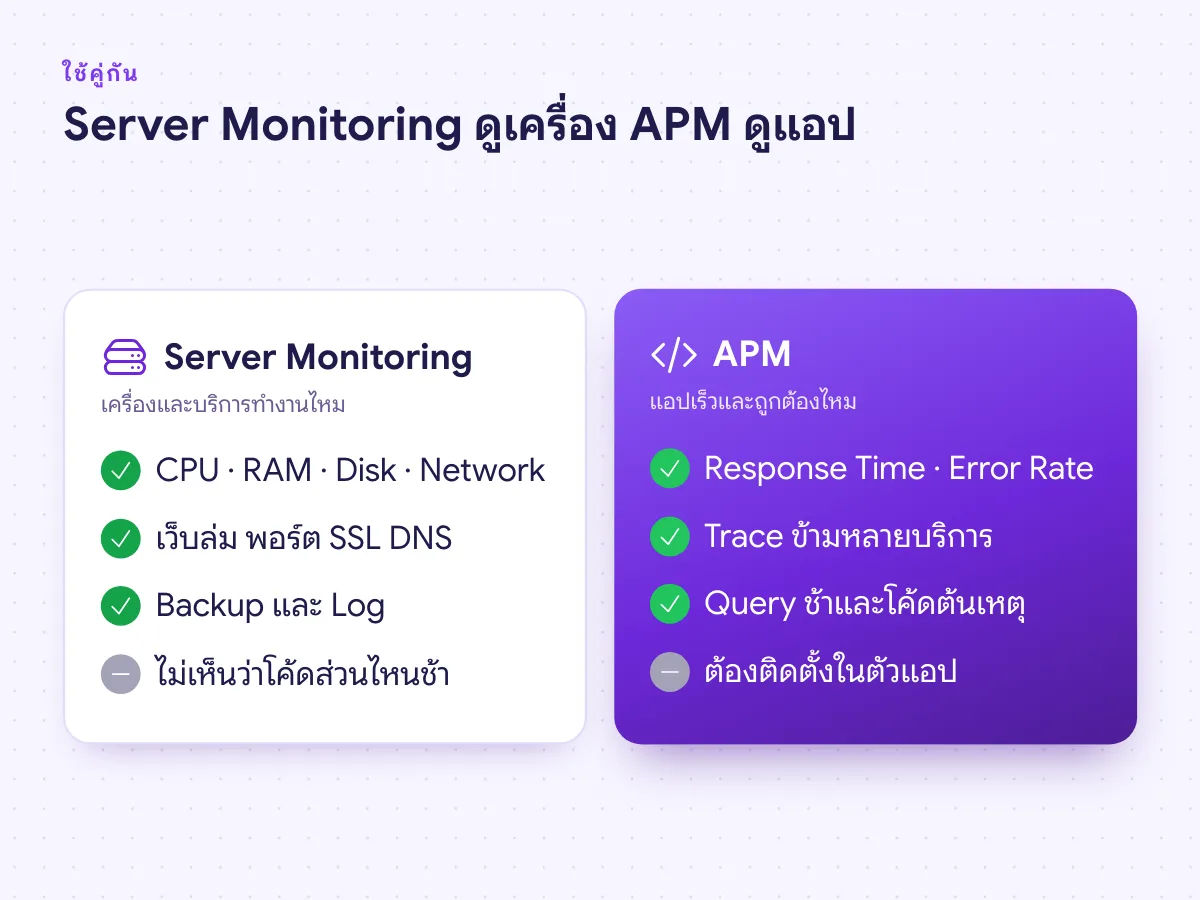
Server Monitoring ตอบว่าเครื่องและบริการยังทำงานดีหรือไม่ เช่น CPU สูง ดิสก์ใกล้เต็ม หรือเว็บล่ม ส่วน APM (Application Performance Monitoring) ตอบว่าภายในแอปเกิดอะไรขึ้น เช่น หน้าชำระเงินช้าเพราะ Query ไหน หรือ Error มาจากโค้ดส่วนใด
องค์กรส่วนใหญ่ควรเริ่มจาก Server Monitoring เพราะเป็นพื้นฐานที่ทุกระบบต้องมี เมื่อแอปมีผู้ใช้จำนวนมาก มีหลายบริการต่อกัน หรือเจอปัญหาช้าที่หาสาเหตุจากกราฟเครื่องไม่ได้ จึงค่อยเพิ่ม APM ทั้งสองแบบส่งข้อมูลเข้าระบบเดียวกันได้
เริ่มใช้ Server Monitoring กับทีมเราใน 4 ขั้นตอน
- 1
บอกระบบที่ต้องดูแล
แจ้งรายการเซิร์ฟเวอร์ เว็บไซต์ และบริการสำคัญ ทีมวิศวกรประเมินระบบและสิ่งที่ Server Monitoring ควรครอบคลุมให้ฟรี
- 2
ออกแบบการตรวจและ Alert
กำหนดสิ่งที่ตรวจ เกณฑ์ ระดับความรุนแรง ผู้รับแจ้ง และขั้นตอนยกระดับร่วมกับทีมของคุณ
- 3
ติดตั้งและปรับเกณฑ์
ติดตั้งเครื่องมือและตัวตรวจจากภายนอก ดูข้อมูลจริงช่วงแรก แล้วปรับเกณฑ์ให้แจ้งเตือนเท่าที่จำเป็น
- 4
เฝ้าระวังและรายงาน
ทีมดูแล Server Monitoring 24/7 รับมือเหตุตามขอบเขตงานและ SLA แล้วส่งรายงานสรุปทุกเดือน
อ่านต่อ / บริการที่เกี่ยวข้อง
- Managed Services ดูแลระบบไอทีครบวงจร
- IT & Server Managed Services รับดูแลเซิร์ฟเวอร์
- Managed Web Services
- Managed Cloud Services
- Managed Security Services
- APM ดูประสิทธิภาพแอปถึงระดับโค้ด
- Dev Support
- SLA ข้อตกลงระดับการให้บริการ
- Cloud Server
- คู่มือ Cloud Server Monitoring บน TDC Enterprise
- ตั้งระบบแจ้งเตือนเมื่อเว็บไซต์ล่ม
- ซอฟต์แวร์ Monitoring ที่รันบน Cloud Server
- คู่มือการใช้งานทั้งหมด
ข้อมูลโดยทีมวิศวกร THAI DATA CLOUD · ตรวจทานล่าสุด
ให้ทีมเราช่วยออกแบบ Server Monitoring ที่แจ้งเตือนเท่าที่จำเป็น
บอกเราว่ามีระบบอะไรบ้าง และเหตุขัดข้องครั้งล่าสุดรู้ได้อย่างไร ทีมวิศวกรจะประเมินสิ่งที่ Server Monitoring ควรครอบคลุมและเสนอขอบเขตที่เหมาะกับองค์กร ปรึกษาฟรี ไม่มีข้อผูกมัด
คำถามที่พบบ่อยเรื่อง Server Monitoring
Server Monitoring คืออะไร
Server Monitoring คือการเฝ้าดูเซิร์ฟเวอร์และบริการอย่างต่อเนื่อง ทั้งทรัพยากรเครื่อง บริการสำคัญ เว็บไซต์ ใบรับรอง SSL และ Log แล้วแจ้งเตือนผู้รับผิดชอบเมื่อค่าใดเกินเกณฑ์ เพื่อแก้ไขได้ก่อนผู้ใช้เจอปัญหา
Server Monitoring ราคาเท่าไร
มีสองแบบ ลูกค้า Cloud Server ตั้ง Resource Health เองได้จากเมนู Monitoring บน TDC Enterprise ส่วนการให้ทีมเฝ้าระวัง 24/7 เป็นส่วนหนึ่งของบริการรับดูแลเซิร์ฟเวอร์ ซึ่งเริ่มต้น 1,500 บาทต่อเดือน ราคาจริงขึ้นกับจำนวนระบบและสิ่งที่ต้องตรวจ ทีมขายประเมินให้ก่อนเริ่มงาน
ใช้ Resource Health บน TDC Enterprise อย่างไร
ไปที่เมนู Monitoring แล้วเลือก Resource Health กด Activate เพื่อเปิดบริการ จากนั้นสร้าง Instance Monitor เลือก Metric Type, Rule, Threshold, Duration, Period และ Instance ที่ต้องการ ระบบส่งอีเมลเตือนตาม Alert Setting แบบตั้งต้นไปยังเจ้าของ Instance
Resource Health แจ้งเตือนทางช่องทางไหน
Alert Setting แบบตั้งต้นส่งอีเมลเตือนไปยังเจ้าของ Instance ถ้าต้องการให้แจ้งหลายคน หลายช่องทาง หรือมีคนรับเหตุนอกเวลา ให้ใช้ Server Monitoring โดยทีม Managed Services ซึ่งออกแบบผู้รับแจ้งและขั้นตอนยกระดับตามโครงสร้างองค์กร
Server Monitoring ต่างจาก APM อย่างไร
Server Monitoring ดูว่าเครื่องและบริการทำงานปกติไหม เช่น CPU ดิสก์ หรือเว็บล่ม ส่วน APM ดูภายในแอปว่าคำขอไหนช้า Query ไหนเป็นต้นเหตุ และ Error มาจากโค้ดส่วนใด ระบบส่วนใหญ่เริ่มจาก Server Monitoring แล้วเพิ่ม APM เมื่อแอปซับซ้อนขึ้น
ต้องเป็นลูกค้า Cloud Server ของ THAI DATA CLOUD ก่อนไหม
Resource Health บน TDC Enterprise ใช้กับ Cloud Instance ของเรา ส่วนการเฝ้าระวังโดยทีม Managed Services ดูแลได้ทั้งเซิร์ฟเวอร์ในสำนักงาน เครื่องที่ฝากวางใน Data Center คลาวด์ของเรา และคลาวด์ของผู้ให้บริการรายอื่น
ควรตั้งเกณฑ์แจ้งเตือน CPU กี่เปอร์เซ็นต์
ไม่มีตัวเลขเดียวที่ถูกกับทุกเครื่อง ควรดูค่าเฉลี่ยรายสัปดาห์ก่อน แล้วตั้งเกณฑ์คู่กับระยะเวลาที่ค่าต้องค้างอยู่ เช่น สูงต่อเนื่องหลายนาที ไม่ใช่แตะครั้งเดียว และควรแจ้งเตือนที่อาการที่ผู้ใช้รู้สึก เช่น เว็บตอบช้า มากกว่าดูตัวเลข CPU อย่างเดียว
Alert Fatigue คืออะไร แก้อย่างไร
Alert Fatigue คือภาวะที่ทีมได้รับแจ้งเตือนมากจนเลิกใส่ใจ แล้วพลาดเหตุจริง แก้ด้วยการแยกระดับความรุนแรง ใช้ระยะเวลายืนยันก่อนแจ้ง จำกัดการแจ้งซ้ำ ให้ทุก Alert มีเจ้าของและขั้นตอนแก้ และลบ Alert ที่ไม่มีใครต้องทำอะไร
Uptime 99.9% หมายถึงระบบล่มได้นานแค่ไหน
ประมาณ 43.2 นาทีต่อเดือนที่มี 30 วัน หรือราว 8.76 ชั่วโมงต่อปี ถ้าระบบพึ่งหลายส่วนที่ได้ 99.9% ต่อกันเป็นทอด Uptime รวมจะต่ำลงตามจำนวนส่วนที่ต่อกัน
ควรตรวจเว็บไซต์ถี่แค่ไหน
ใน Server Monitoring เว็บสำคัญ เช่น หน้าชำระเงิน มักตรวจทุก 1 นาที เว็บทั่วไปทุก 5 นาที และควรยืนยันซ้ำ 2-3 ครั้งก่อนแจ้งว่าล่ม เพื่อไม่ให้แจ้งเตือนผิดจากเครือข่ายสะดุดครั้งเดียว
ทำไมต้องเฝ้าวันหมดอายุใบรับรอง SSL
ใบรับรองที่หมดอายุทำให้เบราว์เซอร์ขึ้นคำเตือนและผู้ใช้เข้าเว็บไม่ได้ทันที และ CA/Browser Forum ลงมติลดอายุสูงสุดของใบรับรอง TLS สาธารณะลงเป็นลำดับจนเหลือ 47 วันในปี 2029 การต่ออายุจะถี่ขึ้น การเตือนล่วงหน้าจึงจำเป็น
ใช้ Zabbix หรือ Prometheus ดี
Zabbix เหมาะกับองค์กรที่มีเซิร์ฟเวอร์และอุปกรณ์เครือข่ายหลายชนิด และอยากได้ Template สำเร็จรูป ส่วน Prometheus กับ Grafana เหมาะกับระบบ Container และทีมที่เขียนกฎแจ้งเตือนเอง ทีมของเราทำงานได้ทั้งสองแบบ และดูแลต่อบนระบบที่องค์กรใช้อยู่ได้
มีระบบมอนิเตอร์อยู่แล้ว ให้ทีมดูแลต่อได้ไหม
ได้ ทีมวิศวกรตรวจชุดการตรวจ Server Monitoring และเกณฑ์ที่มีอยู่ ตัด Alert ที่ไม่จำเป็น เติมจุดที่ยังไม่มีคนเฝ้า เช่น SSL หรือ Backup แล้วรับเหตุต่อตามขอบเขตที่ตกลงกัน
Server Monitoring เหมาะกับใคร
เหมาะกับทุกองค์กรที่มีเว็บไซต์ แอป หรือเซิร์ฟเวอร์ที่ธุรกิจหยุดไม่ได้ ทีมที่มีผู้ดูแลระบบอยู่แล้วตั้งแจ้งเตือนเองบน TDC Enterprise ได้ ส่วนองค์กรที่ไม่มีคนรับเหตุนอกเวลา หรือมีหลายระบบ ควรให้ทีม Managed Services เฝ้าระวังให้
เริ่มใช้งานใช้เวลานานไหม
Resource Health เปิดใช้และสร้าง Monitor ได้เองบน TDC Enterprise ส่วนการเฝ้าระวังโดยทีมขึ้นกับจำนวนระบบและการเข้าถึง ทีมงานแจ้งแผนจริงหลังประเมินระบบ
เมื่อระบบแจ้งเตือนกลางดึก ใครเป็นคนแก้
ในบริการ Managed Services ทีมวิศวกรของเราเฝ้าระวังตลอด 24 ชั่วโมง เมื่อมี Alert ทีมตรวจสอบและแก้ตามขั้นตอนที่ตกลงไว้ในขอบเขตงาน แล้วแจ้งผลกับผู้ติดต่อฝั่งคุณ เวลาตอบสนองเป็นไปตาม SLA และระดับสมาชิกที่ระบุไว้ในหน้า SLA
ขอคำปรึกษา Server Monitoring
กรอกข้อมูลสั้น ๆ ทีมงานจะติดต่อกลับภายใน 1 วันทำการ ปรึกษาฟรี ไม่มีข้อผูกมัด