
Application Performance Monitoring · ดูแอปถึงระดับโค้ดAPM ดู Performance ของแอปพลิเคชันถึงระดับโค้ด รู้ว่าช้าที่ไหนและเพราะอะไร
APM หรือ Application Performance Monitoring จาก THAI DATA CLOUD คือบริการติดตั้งและดูแลระบบวัดประสิทธิภาพของแอปพลิเคชัน ตั้งแต่เวลาตอบสนองของแต่ละคำขอ อัตรา Error ไปจนถึง Query ฐานข้อมูลที่ช้าและโค้ดที่เป็นต้นเหตุ เราติดตั้งด้วย OpenTelemetry เก็บข้อมูลบนคลาวด์ในประเทศไทย ทำ Dashboard และ Alert แล้วทบทวนผลกับทีมของคุณทุกเดือน
- ติดตั้งด้วย OpenTelemetry
- เลือกเก็บข้อมูลในไทยได้
- ปรึกษาฟรี ไม่มีข้อผูกมัด
มาตรฐานที่ได้รับการรับรอง
- Data Center ในไทย TIA-942 Tier 3+
- Uptime SLA 99.9%
LINE ID @thaidatacloudแชทกับฝ่ายขาย
24x7x365 Online Supportดูแลทุกวันตลอด 24 ชม.

2016
ให้บริการคลาวด์ตั้งแต่ปี
Tier 3+
Data Center ในประเทศไทย
99.9%
Uptime เฉลี่ยตาม SLA
24x7x365
ทีมซัพพอร์ตและเฝ้าระวัง
คำตอบสั้น
APM คืออะไร
APM หรือ Application Performance Monitoring คือการวัดประสิทธิภาพของแอปพลิเคชันจากภายในตัวแอป ทั้งเวลาตอบสนอง ปริมาณคำขอ อัตรา Error และเส้นทางของแต่ละคำขอผ่านบริการและฐานข้อมูล ทำให้รู้ว่าระบบช้าที่จุดไหนและเพราะโค้ดหรือ Query ใด ต่างจาก Server Monitoring ที่ดูเพียงทรัพยากรของเครื่อง
ข้อมูลสำคัญ
- APM วัด Response Time แบบ p95/p99, Throughput, Error Rate และ Apdex ของทุก Endpoint
- Distributed Tracing ไล่คำขอหนึ่งครั้งข้ามทุกบริการไปจนถึง Query ฐานข้อมูล
- ติดตั้งด้วย OpenTelemetry มาตรฐานเปิดที่ส่งข้อมูลไปได้หลาย Backend
- ทำงานกับ Elastic APM, Grafana Tempo, Jaeger, SigNoz หรือ License New Relic และ Datadog ที่องค์กรมีอยู่
- เลือกเก็บข้อมูลบนคลาวด์ใน Data Center มาตรฐาน Tier 3+ ในประเทศไทย
- ทบทวนผลรายเดือนกับทีม Managed Services และส่งต่องานแก้โค้ดให้ทีม Dev Support
บริการ APM ของ THAI DATA CLOUD ทำอะไรให้บ้าง
ติดตั้งในแอปให้
ทีมเราติดตั้ง OpenTelemetry ในแอปของคุณ ทั้งแบบวัดอัตโนมัติและจุดที่ต้องวัดเพิ่ม เช่น ขั้นตอนชำระเงิน
โฮสต์ระบบเก็บข้อมูลให้
วางระบบเก็บ Trace, Metric และ Log ของ APM บน Cloud Server ของเรา ดูแลพื้นที่ ระยะเก็บย้อนหลัง และการอัปเดต
ข้อมูลอยู่ในไทยได้
Trace มักมี URL และรหัสผู้ใช้ติดมา เก็บบน Data Center ในกรุงเทพฯ หรือขอนแก่น เพื่อตอบเรื่อง PDPA ได้ชัด
Dashboard และ Alert ที่ใช้ได้จริง
ตั้ง Dashboard ตาม Golden Signals และ Alert ที่อาการซึ่งผู้ใช้รู้สึก ไม่ใช่ทุกตัวเลขที่ขยับ
ทบทวนผลทุกเดือน
สรุป Endpoint ที่ช้าที่สุด Error ที่เพิ่มขึ้น และสิ่งที่ควรแก้ก่อน ร่วมกับทีม Managed Services
พาไปถึงการแก้
เมื่อ APM ชี้โค้ดหรือ Query ที่เป็นต้นเหตุ ทีม Dev Support ช่วยแก้ต่อ หรือส่งรายละเอียดให้ทีมพัฒนาของคุณ
APM ต่างจาก Server Monitoring อย่างไร
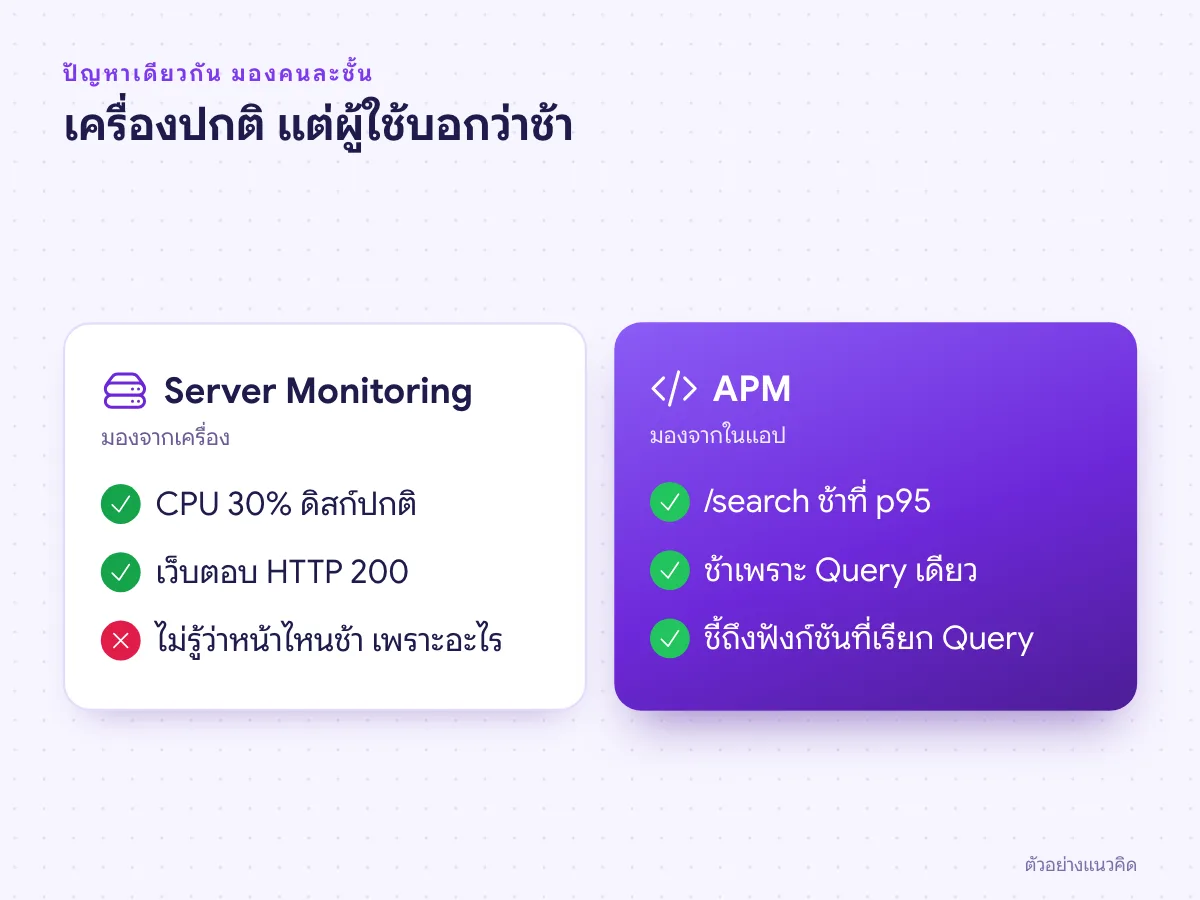
Server Monitoring บอกว่าเครื่องยังดีอยู่ไหม CPU สูงหรือเปล่า ดิสก์เต็มหรือยัง เว็บตอบหรือไม่ แต่เมื่อผู้ใช้บ่นว่าหน้าค้นหาสินค้าช้า ทั้งที่ CPU อยู่ที่ 30% กราฟของเครื่องตอบไม่ได้ว่าช้าเพราะอะไร
APM ติดตั้งอยู่ในตัวแอป จึงเห็นทุกคำขอว่าใช้เวลาที่ส่วนไหน ฟังก์ชันใด เรียก API ภายนอกนานเท่าไร และ Query ใดกินเวลามากที่สุด สองระบบจึงตอบคำถามคนละชั้น และได้ผลดีที่สุดเมื่อใช้คู่กัน
| ประเด็น | Server Monitoring | APM |
|---|---|---|
| คำถามที่ตอบ | เครื่องและบริการทำงานปกติไหม | แอปช้าหรือ Error ที่ไหน เพราะอะไร |
| ข้อมูลหลัก | CPU, RAM, Disk, Network, Uptime | Response Time, Throughput, Error Rate, Trace |
| ติดตั้งที่ไหน | Agent บนเครื่อง หรือตัวตรวจจากภายนอก | SDK หรือ Agent ในตัวแอป |
| ระดับรายละเอียด | รายเครื่อง รายบริการ | ราย Endpoint รายคำขอ ถึง Query และฟังก์ชัน |
| ผู้ใช้หลัก | ผู้ดูแลระบบ | นักพัฒนาและผู้ดูแลระบบร่วมกัน |
APM วัดอะไรบ้าง: Response Time, Throughput, Error Rate และ Apdex
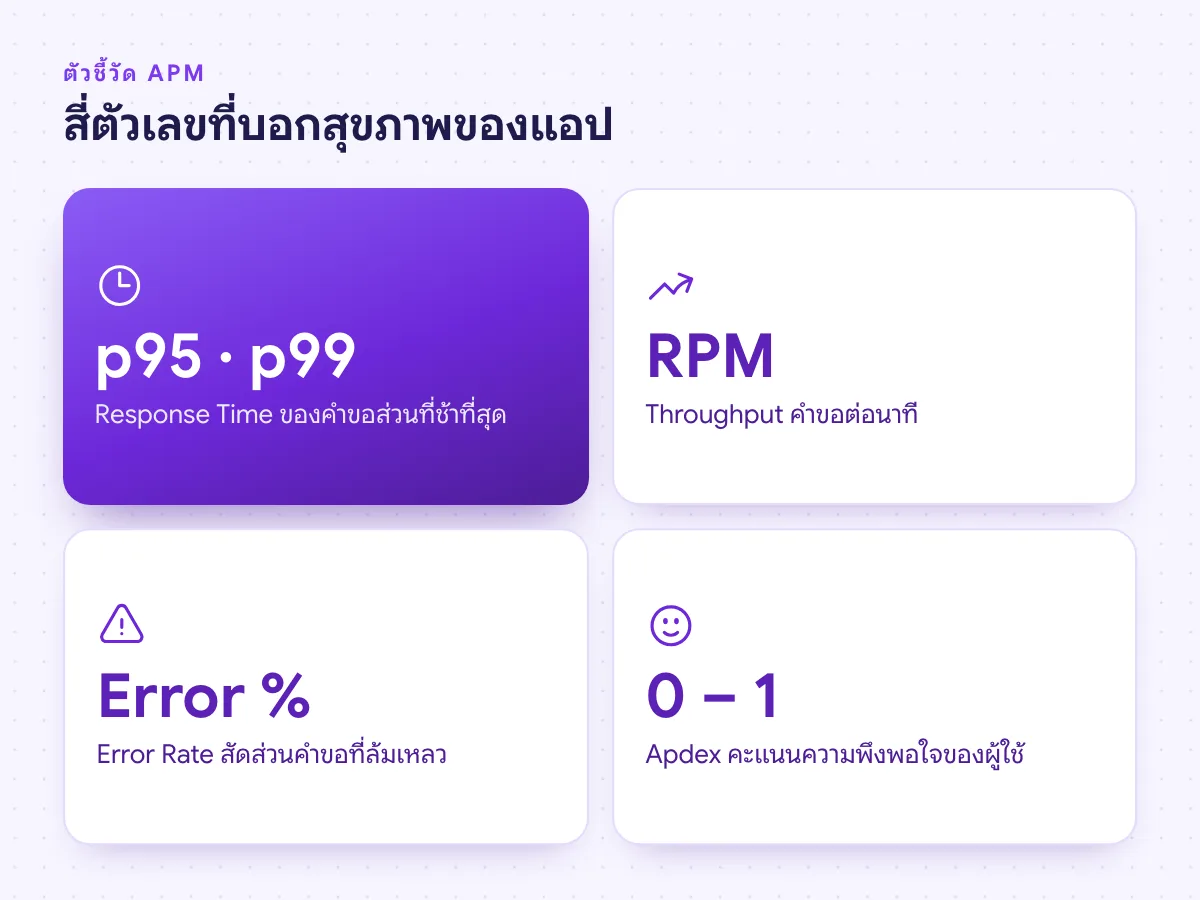
APM สรุปทุกคำขอเป็นตัวเลขไม่กี่ตัวที่บอกสุขภาพของแอป Response Time คือเวลาที่ใช้ตอบหนึ่งคำขอ Throughput คือปริมาณคำขอต่อนาที และ Error Rate คือสัดส่วนคำขอที่ล้มเหลว
ค่าเฉลี่ยมักหลอกตา ถ้า 95 คำขอตอบใน 0.2 วินาที แต่อีก 5 คำขอใช้ 8 วินาที ค่าเฉลี่ยยังดูดีที่ราว 0.6 วินาที ทั้งที่ผู้ใช้ 1 ใน 20 รอนานจนปิดหน้าเว็บ APM จึงดูค่า Percentile เช่น p95 และ p99 ซึ่งบอกว่าคำขอส่วนที่ช้าที่สุดช้าแค่ไหน
Apdex เป็นคะแนนความพึงพอใจตั้งแต่ 0 ถึง 1 กำหนดเวลาเป้าหมาย T แล้วนับคำขอที่เร็วกว่า T เป็นพอใจ ช้ากว่า T แต่ไม่เกิน 4T เป็นพอทน ที่เหลือหรือคำขอที่ Error เป็นไม่พอใจ สูตรคือ (พอใจ + พอทน ÷ 2) ÷ ทั้งหมด เช่น 200 คำขอ พอใจ 170 พอทน 20 ได้ Apdex 0.9
| ตัวชี้วัด | บอกอะไร | ตัวอย่างการใช้ |
|---|---|---|
| Response Time (p95, p99) | คำขอส่วนที่ช้าที่สุดช้าแค่ไหน | ตั้งเป้าให้หน้าชำระเงินตอบภายในเวลาที่กำหนด |
| Throughput | ปริมาณคำขอต่อนาที | เห็นช่วงที่คนใช้มาก และวางแผนขยายระบบ |
| Error Rate | สัดส่วนคำขอที่ล้มเหลว | แจ้งเตือนเมื่อ Error เพิ่มหลังปล่อยเวอร์ชันใหม่ |
| Apdex | คะแนนความพึงพอใจ 0 ถึง 1 | รายงานผู้บริหารด้วยตัวเลขเดียว |
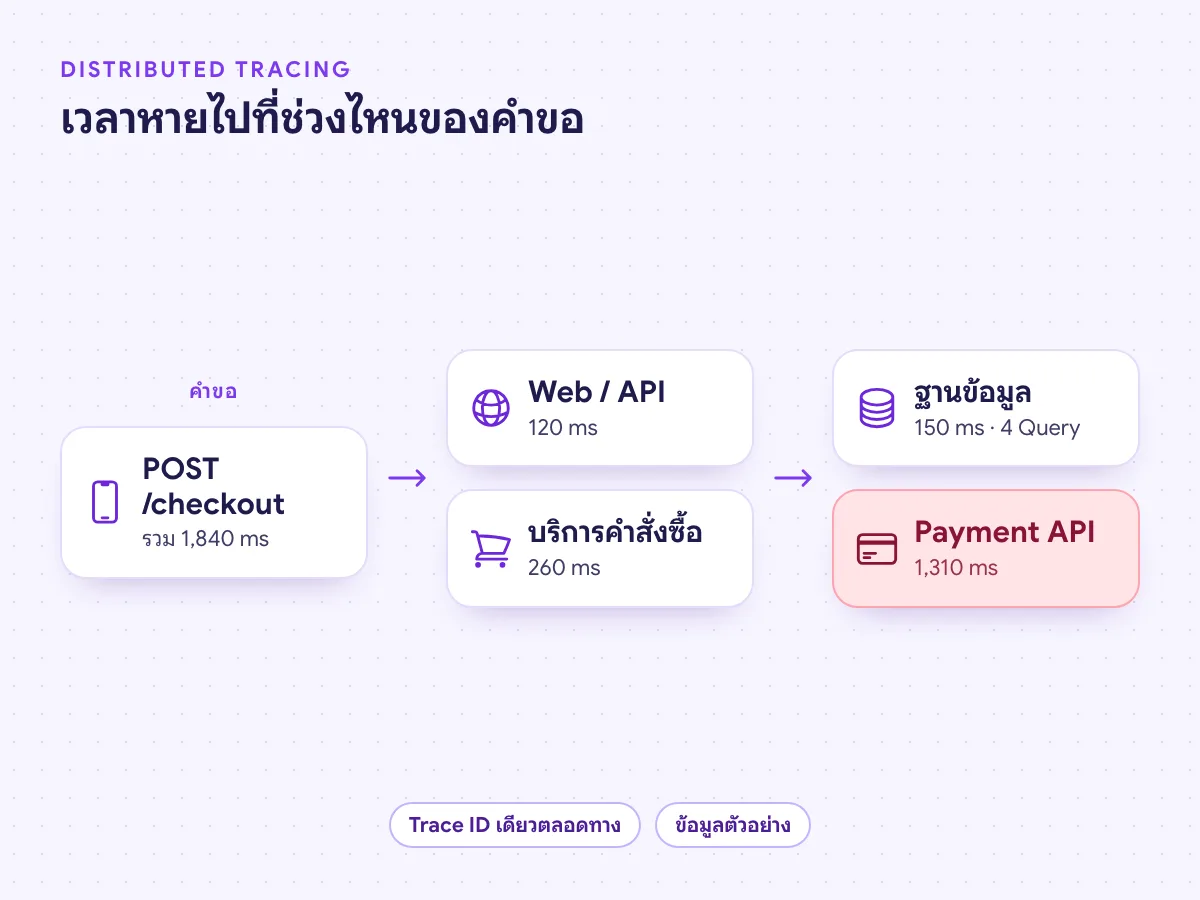
Distributed Tracing ใน APM ไล่คำขอหนึ่งครั้งผ่านทุกบริการ
แอปสมัยใหม่ไม่ได้อยู่ในเครื่องเดียว คำขอหนึ่งครั้งอาจผ่านหน้าเว็บ API Gateway บริการสินค้า บริการชำระเงิน แคช และฐานข้อมูล เมื่อผลรวมช้า ทีมแต่ละฝั่งมักบอกว่าฝั่งตัวเองปกติ
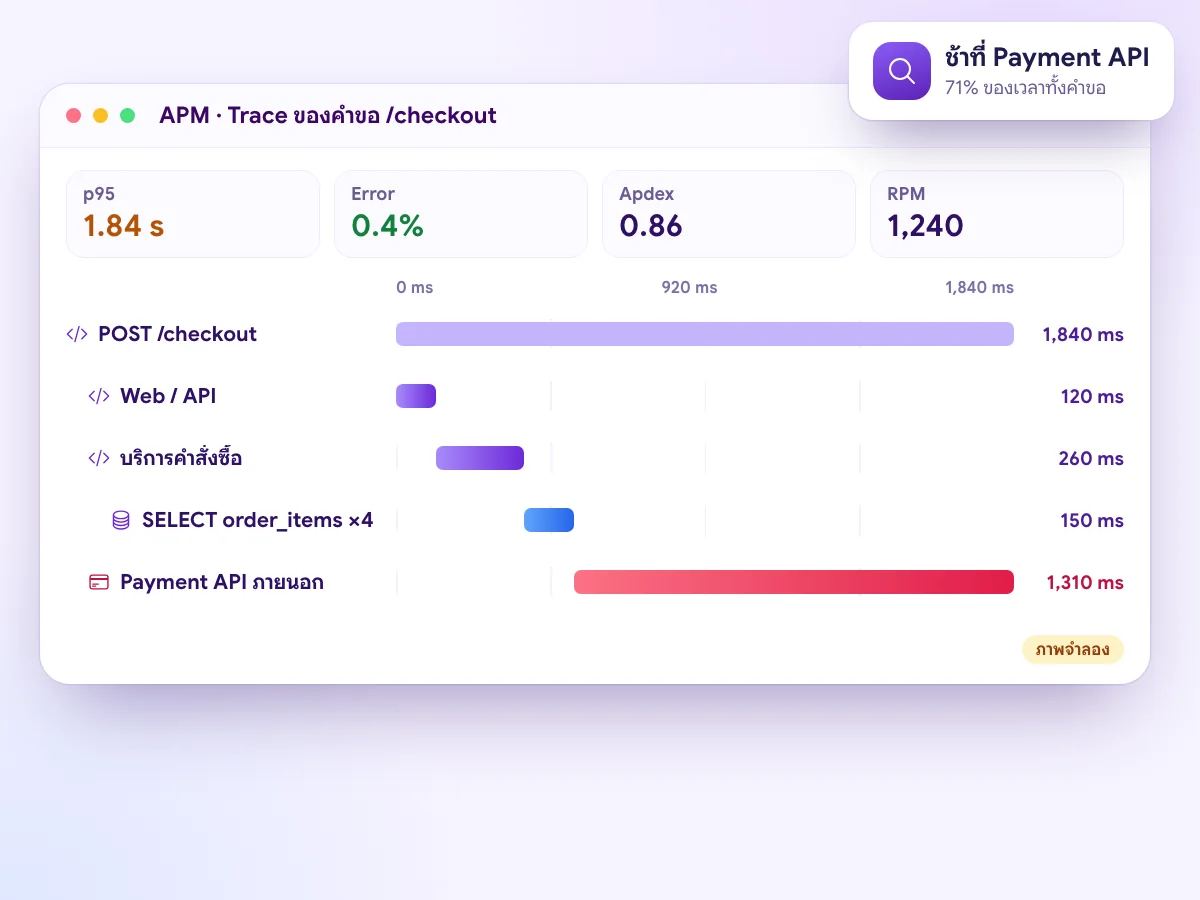
Distributed Tracing แก้ปัญหานี้ด้วยการติดรหัสเดียวกัน (Trace ID) ไปกับคำขอตลอดทาง แต่ละช่วงที่ผ่านเรียกว่า Span มีเวลาเริ่ม เวลาจบ และรายละเอียด เช่น Query ที่รัน เมื่อนำ Span มาเรียงเป็นแผนภาพน้ำตก จะเห็นทันทีว่าเวลาหายไปที่ช่วงไหน
มาตรฐาน W3C Trace Context กำหนดวิธีส่งรหัสนี้ข้ามบริการผ่าน HTTP Header บริการที่เขียนด้วยภาษาต่างกันจึงต่อ Trace เดียวกันได้ และ APM ทุกตัวที่รองรับ OpenTelemetry อ่านรหัสชุดเดียวกัน
- เห็นบริการที่เป็นคอขวด แทนการเดาจากกราฟของแต่ละเครื่อง
- เห็นการเรียกซ้ำ เช่น Query เดิมหลายสิบครั้งในคำขอเดียว
- เห็นเวลาที่รอ API ภายนอก เช่น Payment Gateway หรือบริการส่ง SMS
หา Query ฐานข้อมูลที่ช้าด้วย APM แทนการเดา
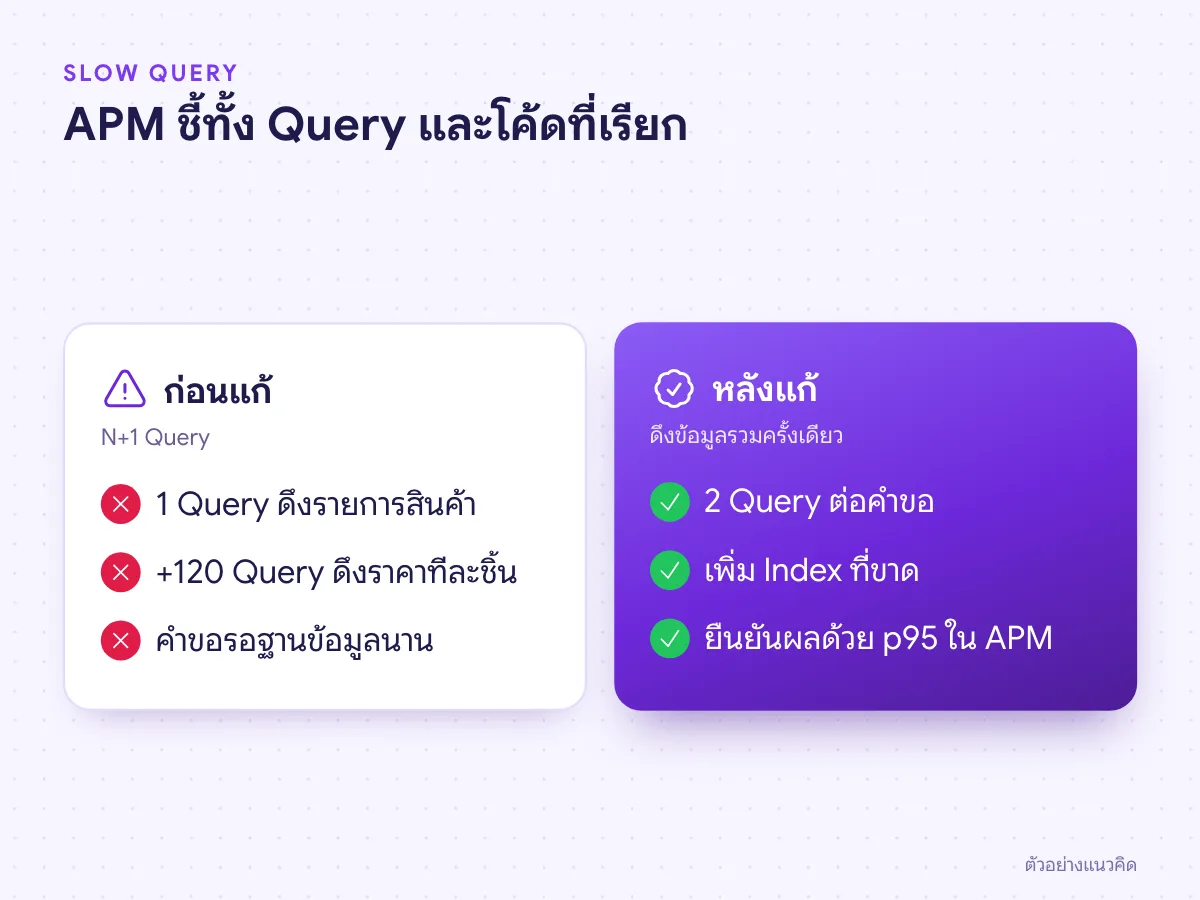
สาเหตุที่พบบ่อยของแอปช้าคือฐานข้อมูล แต่ไม่ใช่เพราะเครื่องฐานข้อมูลเล็กเสมอไป ปัญหาที่เจอบ่อยกว่าคือ Query ที่ไม่มี Index, Query เดิมที่ถูกเรียกซ้ำในลูป (N+1) และการเชื่อมต่อที่หมด Pool จนคำขอต้องรอคิว
Slow Query Log ของ MySQL บอกว่า Query ไหนช้า แต่ไม่บอกว่าถูกเรียกจากหน้าไหนของแอป APM เชื่อมสองฝั่งนี้เข้าด้วยกัน เห็นทั้ง Query ที่ช้า จำนวนครั้งที่ถูกเรียกต่อคำขอ และฟังก์ชันที่เรียก ทีมพัฒนาจึงแก้ถูกจุดในรอบเดียว
เว็บ WordPress ใช้ปลั๊กอิน Query Monitor ดูเรื่องเดียวกันได้ทีละหน้า ส่วนระบบที่มีผู้ใช้จริงจำนวนมาก APM เก็บข้อมูลจากทุกคำขอ โดยไม่ต้องเปิดหน้าเว็บทดสอบทีละหน้า
Real User Monitoring และ Core Web Vitals: APM ฝั่งเบราว์เซอร์
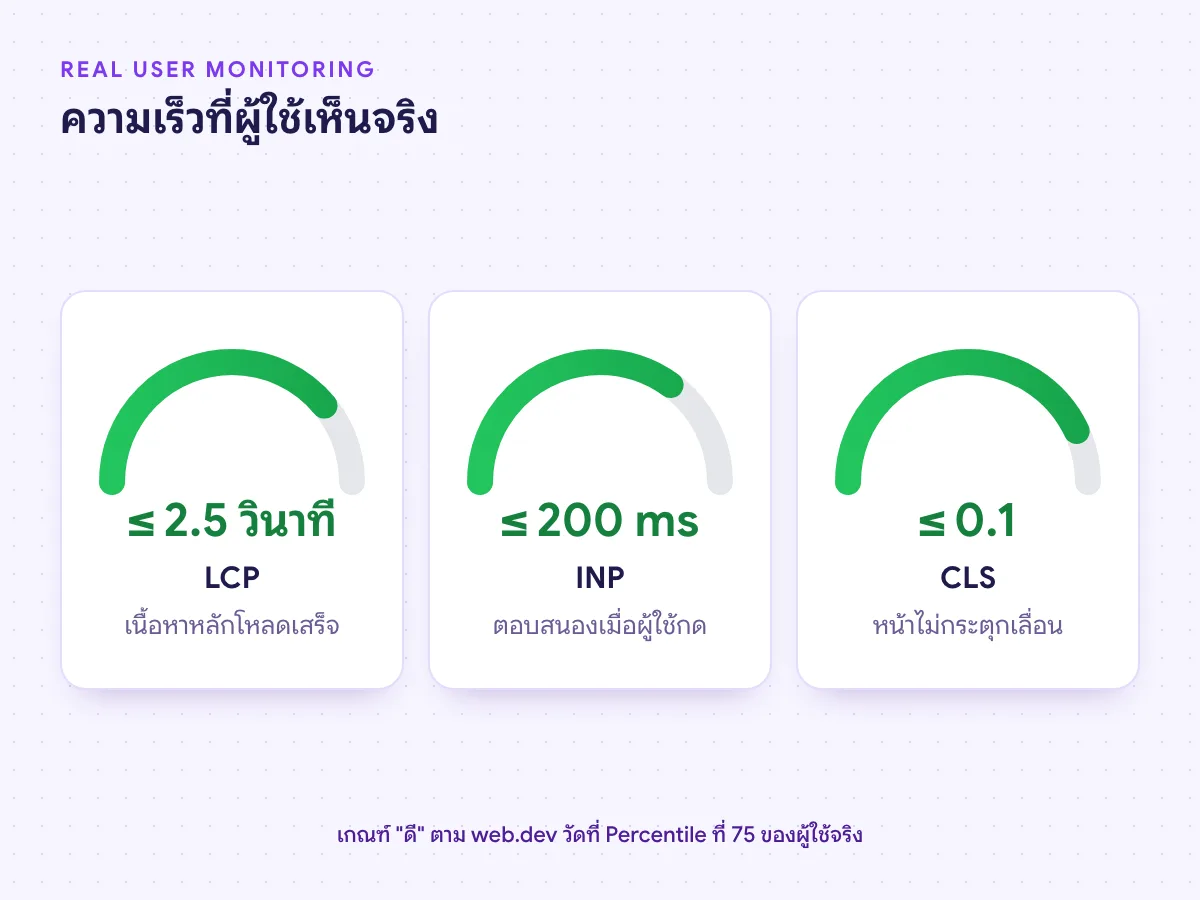
เซิร์ฟเวอร์ตอบเร็วไม่ได้แปลว่าผู้ใช้เห็นหน้าเว็บเร็ว รูปขนาดใหญ่ JavaScript ที่หนัก และเครือข่ายมือถือเพิ่มเวลาได้อีกหลายวินาที Real User Monitoring (RUM) คือ APM ฝั่งเบราว์เซอร์ ที่เก็บเวลาจากอุปกรณ์ของผู้ใช้จริง แยกตามหน้า อุปกรณ์ และเครือข่าย
ตัวชี้วัดที่ใช้กันเป็นมาตรฐานคือ Core Web Vitals ของ Google เกณฑ์ที่ถือว่าดีคือ LCP ไม่เกิน 2.5 วินาที INP ไม่เกิน 200 มิลลิวินาที และ CLS ไม่เกิน 0.1 โดยวัดที่ Percentile ที่ 75 ของการเปิดหน้า แยกมือถือกับเดสก์ท็อป
การทดสอบแบบ Lab เช่น PageSpeed Insights ช่วยหาสาเหตุได้ดี แต่ RUM บอกว่าผู้ใช้เจออะไรจริง เมื่อเชื่อม RUM กับ Trace ฝั่งเซิร์ฟเวอร์ จะไล่ได้ตั้งแต่ปุ่มที่ผู้ใช้กดจนถึง Query ที่ช้า
Logs, Metrics และ Traces เชื่อมกันอย่างไรใน APM
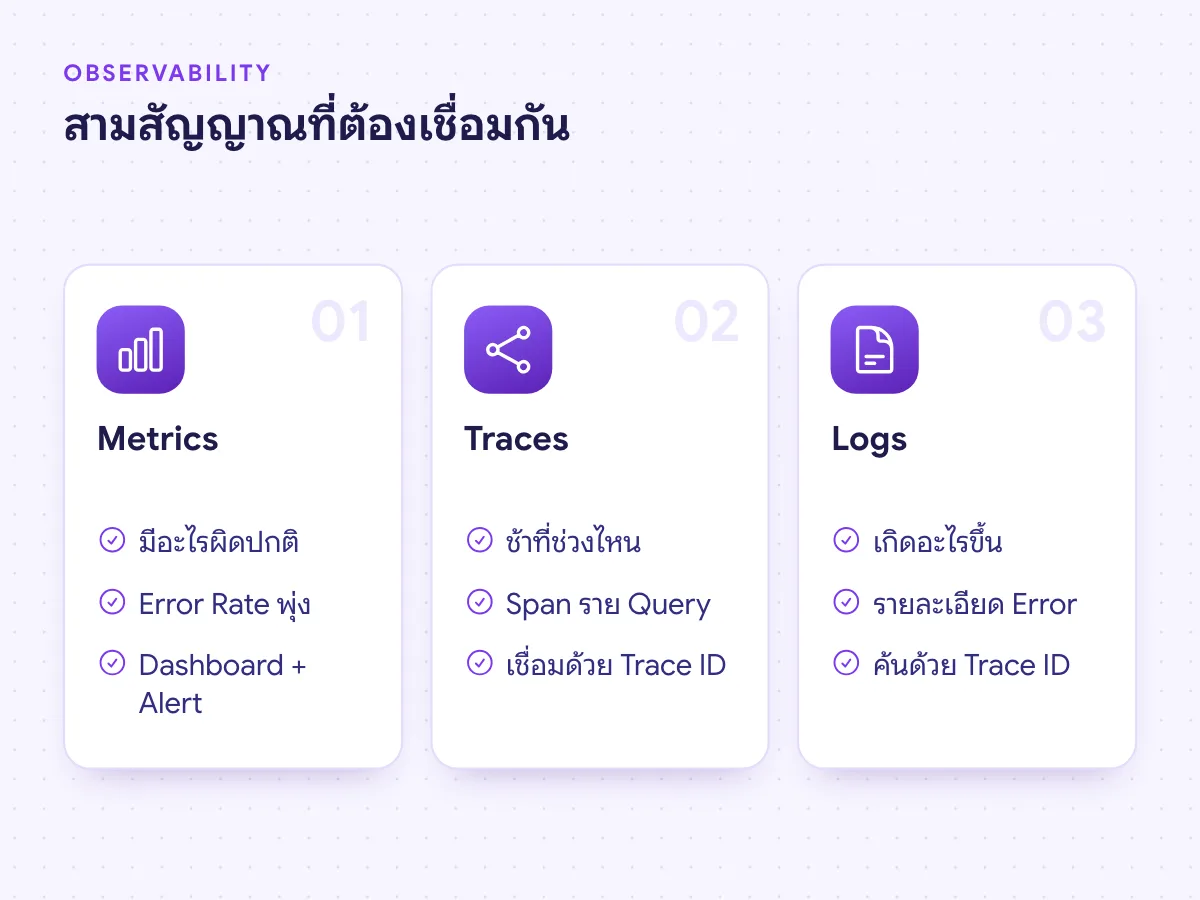
ระบบที่ดูแลง่ายใช้ข้อมูลสามแบบร่วมกัน Metrics เป็นตัวเลขตามเวลาที่บอกว่ามีอะไรผิดปกติ เช่น Error Rate พุ่ง Traces บอกว่าคำขอที่มีปัญหาช้าหรือพังที่ช่วงไหน และ Logs บอกรายละเอียดว่าเกิดอะไรขึ้นในจังหวะนั้น
จุดที่ทำให้สามอย่างนี้มีค่าจริงคือการเชื่อมกัน เมื่อแอปเขียน Trace ID ลงในทุกบรรทัด Log ทีมงานคลิกจากจุดพุ่งบนกราฟไปยัง Trace ตัวอย่าง แล้วไปยัง Log ของคำขอนั้นได้ในไม่กี่คลิก แทนการค้น Log จากหลายเครื่องด้วยเวลาโดยประมาณ
- Metrics: เก็บได้นาน ใช้พื้นที่น้อย เหมาะกับ Dashboard และ Alert
- Traces: มักสุ่มเก็บบางส่วน (Sampling) เพื่อคุมพื้นที่ และตั้งให้เก็บคำขอที่ Error หรือช้าไว้ทั้งหมดได้
- Logs: รวมไว้ที่เดียว และเขียนเป็นโครงสร้าง เช่น JSON เพื่อค้นได้เร็ว
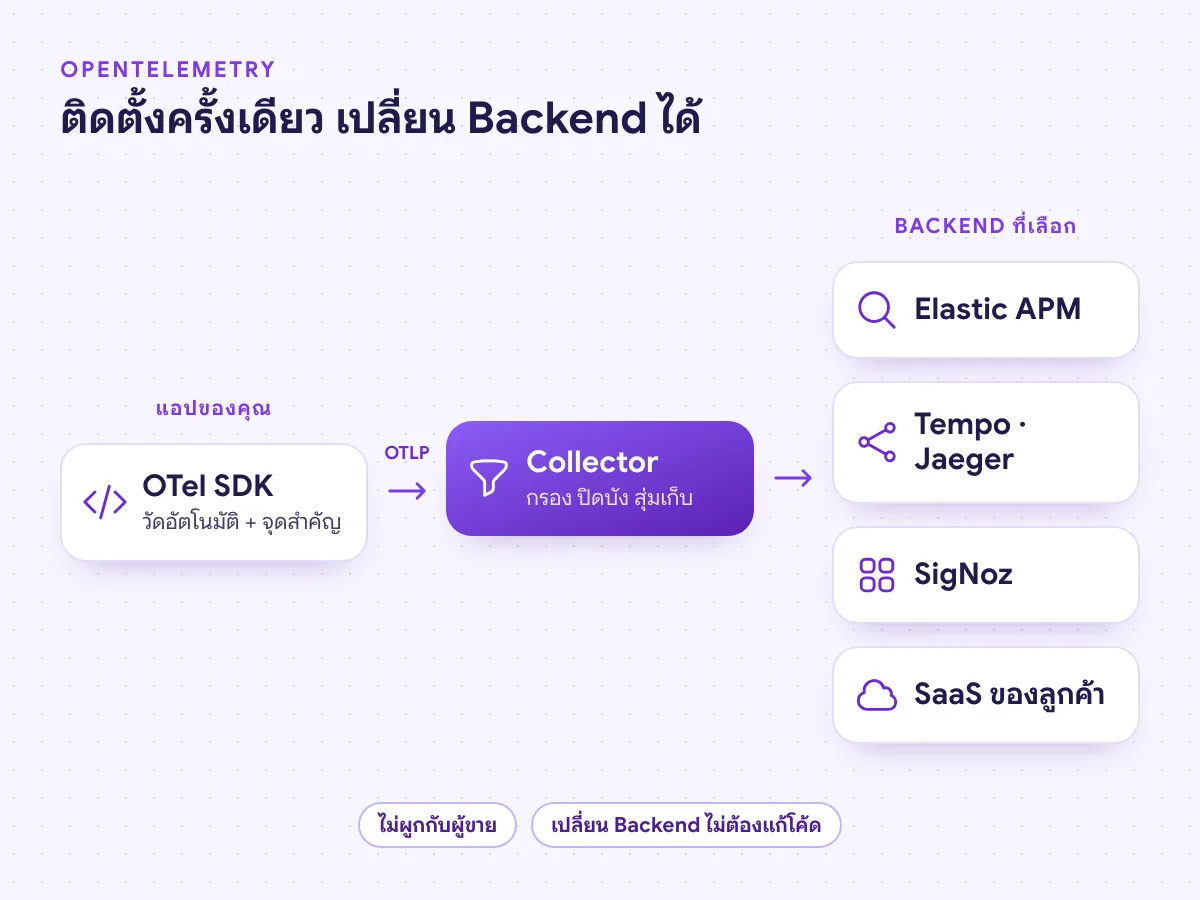
OpenTelemetry: ติดตั้ง APM ครั้งเดียว เปลี่ยน Backend ได้ภายหลัง
เดิมเครื่องมือ APM แต่ละเจ้ามี Agent ของตัวเอง เปลี่ยนผู้ขายเมื่อไรต้องติดตั้งในแอปใหม่ทั้งหมด OpenTelemetry เป็นโครงการโอเพนซอร์สที่กำหนดวิธีเก็บและส่ง Traces, Metrics และ Logs แบบกลาง ไม่ผูกกับผู้ขายหรือเครื่องมือใด และไม่ได้เป็น Backend เก็บข้อมูลเอง
แอปติดตั้ง SDK ของ OpenTelemetry ซึ่งหลายภาษามีแบบวัดอัตโนมัติ (Auto-instrumentation) สำหรับ Framework ที่ใช้กันมาก ข้อมูลส่งด้วยโปรโตคอล OTLP ไปยัง Collector ที่ทำหน้าที่กรอง ปิดบังข้อมูลส่วนบุคคล และสุ่มเก็บ แล้วส่งต่อไปยัง Backend ที่เลือก จะส่งไปมากกว่าหนึ่งที่พร้อมกันก็ได้
ผลคือองค์กรเริ่ม APM ด้วย Backend โอเพนซอร์สบนคลาวด์ในไทย แล้วย้ายหรือเพิ่มบริการ SaaS ภายหลังได้ โดยไม่ต้องแก้โค้ดในแอปซ้ำ
Golden Signals, RED และ USE: กรอบคิดตั้ง Dashboard และ Alert ของ APM
Dashboard ที่มีกราฟเป็นร้อยช่วยอะไรไม่ได้ตอนเกิดเหตุ ทีมที่ดูแลระบบใหญ่จึงเลือกตัวชี้วัดตามกรอบคิดที่ใช้กันแพร่หลาย หนังสือ Site Reliability Engineering ของ Google แนะนำ Four Golden Signals ได้แก่ Latency, Traffic, Errors และ Saturation ว่าถ้าวัดได้แค่สี่ค่าของระบบที่ผู้ใช้ใช้งาน ให้วัดสี่ค่านี้
วิธี RED ของ Tom Wilkie ย่อให้เหลือสามค่าสำหรับทุกบริการ คือ Rate, Errors และ Duration เหมาะกับ APM ของบริการย่อยแต่ละตัว ส่วนวิธี USE ของ Brendan Gregg ใช้กับทรัพยากร เช่น CPU ดิสก์ และ Connection Pool โดยตรวจ Utilization, Saturation และ Errors ซึ่งเป็นงานฝั่ง Server Monitoring
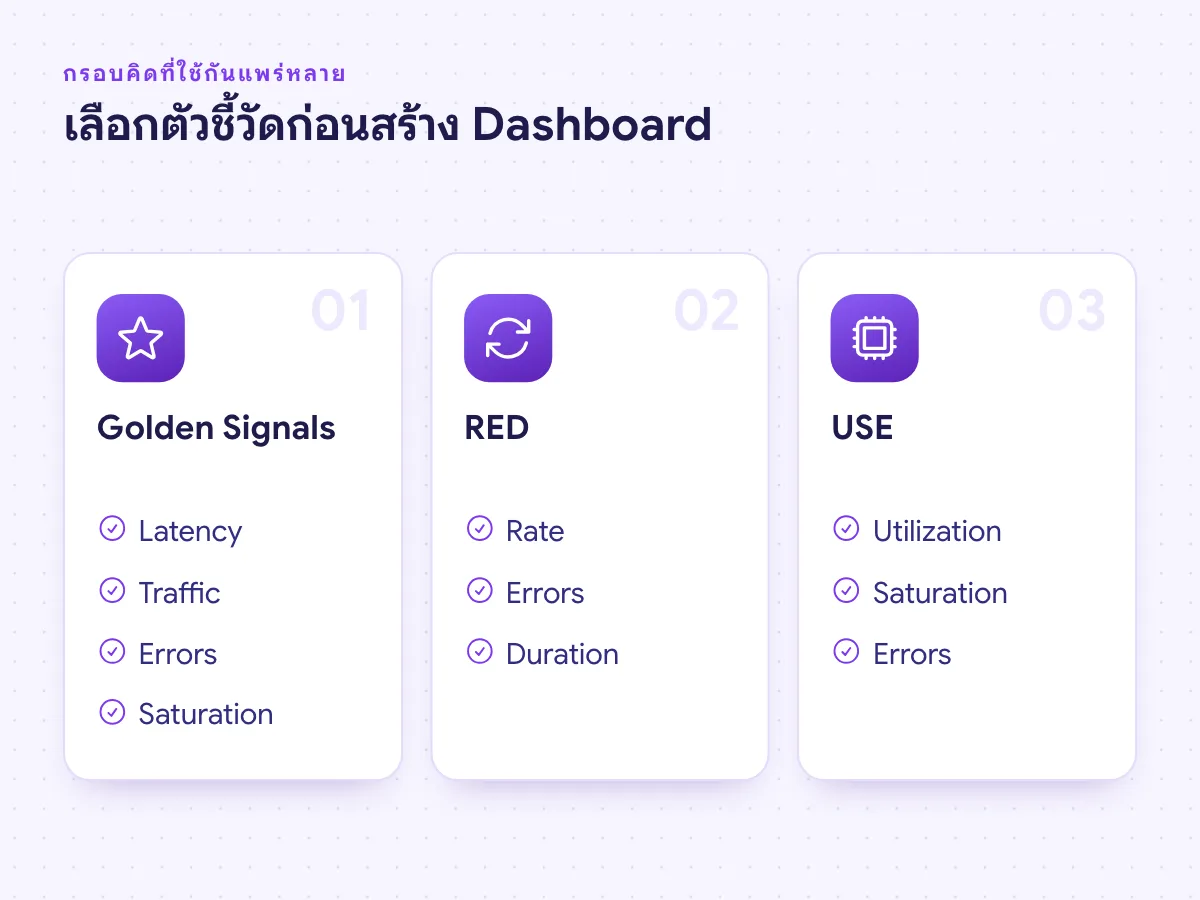
| กรอบคิด | วัดอะไร | ใช้กับ |
|---|---|---|
| Four Golden Signals | Latency, Traffic, Errors, Saturation | ระบบที่ผู้ใช้ใช้งานโดยรวม |
| RED | Rate, Errors, Duration | บริการและ Endpoint แต่ละตัว (APM) |
| USE | Utilization, Saturation, Errors | ทรัพยากร เช่น CPU ดิสก์ Pool (Server Monitoring) |
เครื่องมือ APM ที่ทีมทำงานด้วยได้: โอเพนซอร์สหรือ License ที่คุณมี
THAI DATA CLOUD ไม่ได้ขาย APM ยี่ห้อของตัวเอง ทีมงานเลือกเครื่องมือตามข้อมูลที่ต้องเก็บ งบ และเครื่องมือที่องค์กรใช้อยู่ ทุกตัวในตารางรับข้อมูลจาก OpenTelemetry ได้
ถ้าองค์กรมี License ของ New Relic หรือ Datadog อยู่แล้ว เราติดตั้งและตั้งค่าให้ส่งข้อมูลเข้าบัญชีของคุณได้ ส่วนองค์กรที่ต้องการให้ข้อมูลอยู่ในประเทศ เราวาง Backend โอเพนซอร์สบน Cloud Server ใน Data Center ของเราในกรุงเทพฯ หรือขอนแก่น
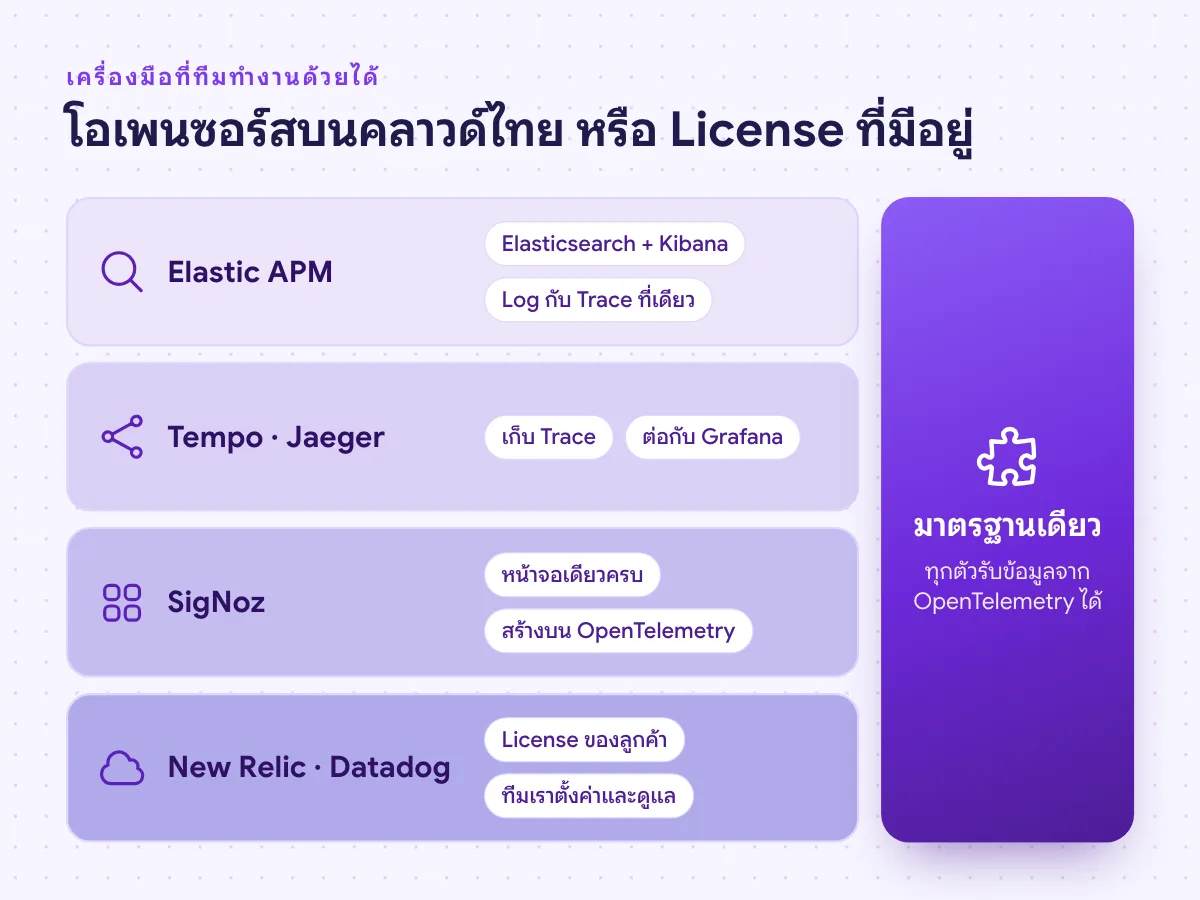
| เครื่องมือ | ลักษณะ | เหมาะกับ |
|---|---|---|
| Elastic APM | APM บน Elasticsearch และ Kibana ค้น Log กับ Trace ในที่เดียว | องค์กรที่ใช้ Elastic Stack เก็บ Log อยู่แล้ว |
| Grafana Tempo / Jaeger | เก็บและดู Trace แบบโอเพนซอร์ส Tempo ต่อกับ Grafana, Prometheus และ Loki ได้ตรง | ทีมที่ใช้ Prometheus และ Grafana อยู่ |
| SigNoz | Traces, Metrics และ Logs ในหน้าจอเดียว สร้างบน OpenTelemetry | ทีมที่ต้องการชุดเดียวจบแบบโอเพนซอร์ส |
| New Relic / Datadog | บริการ SaaS ใช้ License ของลูกค้า | องค์กรที่มีสัญญาอยู่แล้ว และส่งข้อมูลออกนอกประเทศได้ |
บริการ APM ของ THAI DATA CLOUD: ติดตั้ง ดูแล และพาไปถึงการแก้โค้ด
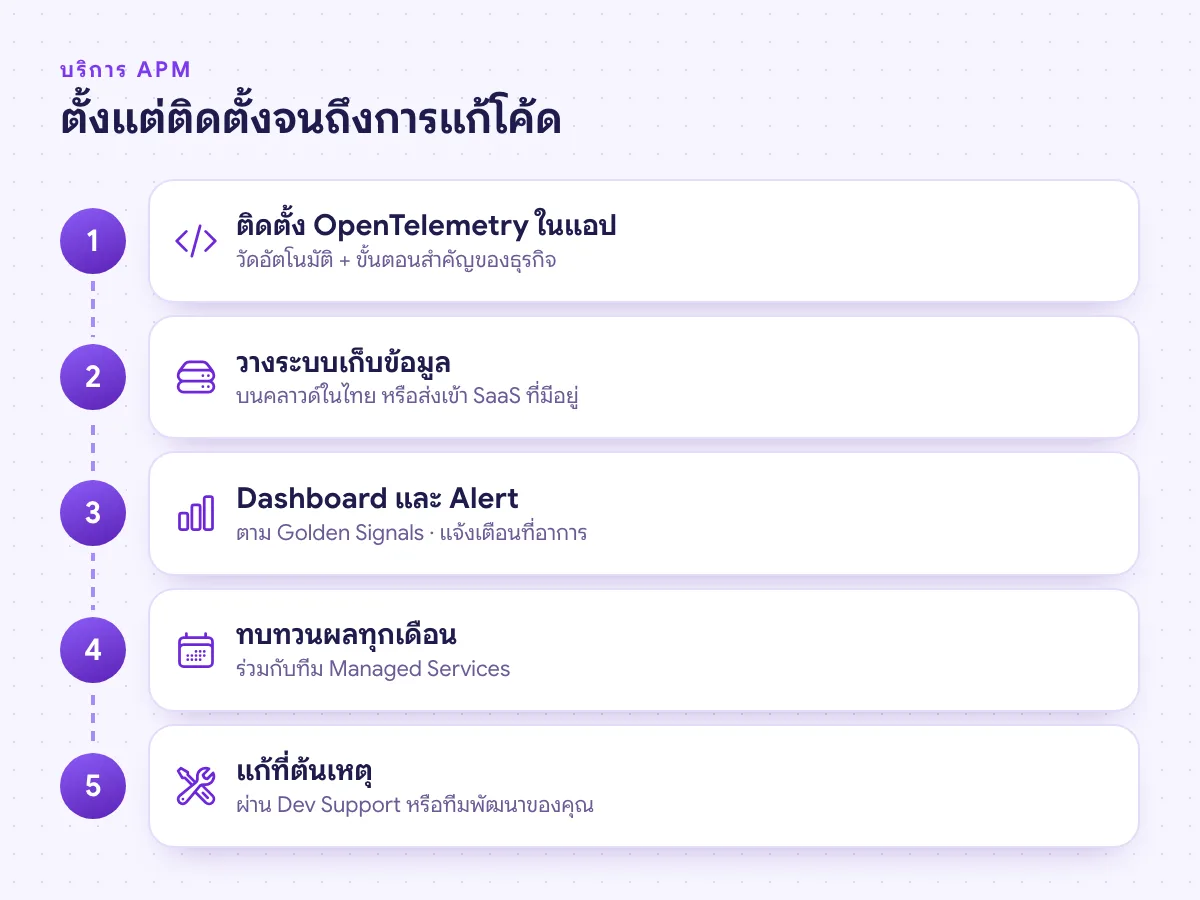
บริการ APM ของเรารับทั้งงานติดตั้งและงานดูแลต่อ ทีมงานติดตั้ง OpenTelemetry ในแอปและเพิ่มจุดวัดในขั้นตอนที่สำคัญกับธุรกิจ วางระบบเก็บข้อมูลบนคลาวด์ของเรา ตั้ง Dashboard และ Alert แล้วดูแลพื้นที่ ระยะเก็บย้อนหลัง และการอัปเดตของระบบทั้งชุด
ทุกเดือน ทีม Managed Services สรุป Endpoint ที่ช้าที่สุด Error ที่เพิ่มขึ้น และสิ่งที่ควรแก้ก่อน เมื่อพบโค้ดหรือ Query ที่เป็นต้นเหตุ ทีม Dev Support ช่วยแก้ต่อได้ หรือส่งรายละเอียดพร้อม Trace ตัวอย่างให้ทีมพัฒนาของคุณ
Trace และ Log มักมีข้อมูลส่วนบุคคลติดมา เช่น อีเมลใน URL หรือรหัสลูกค้า เราตั้ง Collector ให้ปิดบังข้อมูลเหล่านี้ก่อนบันทึก และเก็บข้อมูล APM บน Data Center ในประเทศไทยได้ ช่วยให้องค์กรตอบคำถามเรื่อง PDPA ได้ชัดเจน
เริ่มใช้ APM กับทีมเราใน 4 ขั้นตอน
- 1
เล่าปัญหาและระบบ
บอกแอปที่ช้าหรือ Error บ่อย ภาษาและ Framework ที่ใช้ และที่ตั้งของระบบ ทีมงานประเมินให้ฟรี
- 2
เลือก Backend และขอบเขต
ตกลงว่า APM จะเก็บข้อมูลอะไร นานเท่าไร เก็บในไทยหรือส่งเข้า SaaS ที่มี แล้วเสนอราคาตามขอบเขต
- 3
ติดตั้งและตั้ง Dashboard
ติดตั้ง OpenTelemetry ทดสอบบน Staging ก่อนขึ้นระบบจริง แล้วตั้ง Dashboard และ Alert ตามบริการสำคัญ
- 4
ทบทวนและแก้ต่อเนื่อง
ทบทวนผล APM ทุกเดือนกับทีม Managed Services และส่งงานแก้โค้ดหรือ Query ให้ Dev Support หรือทีมของคุณ
อ่านต่อ / บริการที่เกี่ยวข้อง
- Server Monitoring เฝ้าระวังและแจ้งเตือน
- Dev Support
- Managed Services
- Managed Web Services
- IT & Server Managed Services
- DevOps
- Software Development
- Cloud Server
- Query Monitor: หาสาเหตุเว็บ WordPress ช้า
- PageSpeed Insights และ Core Web Vitals
- MySQL Slow Query Log
- ซอฟต์แวร์ Monitoring ที่รันบน Cloud Server
- SLA ข้อตกลงระดับการให้บริการ
ข้อมูลโดยทีมวิศวกร THAI DATA CLOUD · ตรวจทานล่าสุด
บอกเราว่าแอปช้าตรงไหน แล้วเราจะช่วยหาว่าเพราะอะไร
เล่าระบบของคุณและอาการที่ผู้ใช้เจอ ทีมวิศวกรจะประเมินว่าควรวัดอะไร เก็บข้อมูลที่ไหน และเสนอขอบเขตบริการ APM ที่เหมาะกับองค์กร ปรึกษาฟรี ไม่มีข้อผูกมัด
คำถามที่พบบ่อยเรื่อง APM
APM คืออะไร
APM คือการวัดประสิทธิภาพของแอปพลิเคชันจากภายในตัวแอป ทั้งเวลาตอบสนอง ปริมาณคำขอ อัตรา Error และเส้นทางของแต่ละคำขอผ่านบริการและฐานข้อมูล ทำให้รู้ว่าระบบช้าที่จุดไหนและเพราะอะไร
APM ย่อมาจากอะไร
APM ย่อมาจาก Application Performance Monitoring บางแหล่งใช้ Application Performance Management ความหมายเดียวกันคือการวัดและดูแลประสิทธิภาพของแอปพลิเคชันจากภายในตัวแอป
APM ต่างจาก Server Monitoring อย่างไร
Server Monitoring ดูว่าเครื่องและบริการทำงานปกติไหม เช่น CPU ดิสก์ หรือเว็บล่ม ส่วน APM ดูภายในแอปว่าคำขอไหนช้า Query ไหนเป็นต้นเหตุ และ Error มาจากโค้ดส่วนใด ทั้งสองแบบใช้คู่กันได้ดีที่สุด
บริการ APM ราคาเท่าไร
ขึ้นกับจำนวนแอปและบริการ ปริมาณคำขอ ระยะเวลาเก็บข้อมูล และ Backend ที่เลือก งานติดตั้งและงานดูแลประเมินราคาหลังดูระบบ ส่วนค่าเซิร์ฟเวอร์ที่ใช้เก็บข้อมูลคิดตามสเปก Cloud Server ที่ใช้จริง ขอใบเสนอราคาได้จากฟอร์มด้านล่าง
ติดตั้ง APM แล้วแอปช้าลงไหม
การวัดผลมีต้นทุนเล็กน้อยเสมอ แต่ควบคุมได้ด้วยการสุ่มเก็บ Trace (Sampling) และเลือกจุดวัดเท่าที่จำเป็น ทีมงานทดสอบบน Staging และเทียบเวลาตอบสนองก่อนและหลังติดตั้ง ก่อนเปิดใช้บนระบบจริง
ต้องแก้โค้ดแอปเพื่อติดตั้ง APM ไหม
หลายภาษามีแบบวัดอัตโนมัติของ OpenTelemetry ที่เพิ่มได้โดยแก้โค้ดน้อยมาก เช่น ตั้งค่าผ่าน Agent หรือตัวแปรสภาพแวดล้อม ส่วนขั้นตอนธุรกิจเฉพาะ เช่น การคำนวณราคา ต้องเพิ่มจุดวัดในโค้ดเอง ทีมงานแนะนำและทำให้ได้
APM รองรับภาษาอะไรบ้าง
OpenTelemetry มี SDK สำหรับภาษาหลัก เช่น Java, .NET, Python, Node.js, Go และ PHP ความพร้อมของแต่ละภาษาและ Framework ต่างกัน ทีมงานตรวจกับระบบจริงของคุณก่อนเสนอแผน
OpenTelemetry คืออะไร
OpenTelemetry คือโครงการโอเพนซอร์สที่กำหนดวิธีเก็บและส่ง Traces, Metrics และ Logs แบบกลาง ไม่ผูกกับผู้ขายรายใด แอปติดตั้งครั้งเดียวแล้วส่งข้อมูลไปยัง Backend ใดก็ได้ เช่น Jaeger, Prometheus หรือบริการเชิงพาณิชย์
ใช้ New Relic หรือ Datadog อยู่แล้ว ให้ทีมดูแลได้ไหม
ได้ เราตั้งค่าและดูแลการส่งข้อมูลเข้าบัญชีที่องค์กรมีอยู่ ทำ Dashboard และ Alert และทบทวนผลรายเดือน ค่า License ยังเป็นสัญญาระหว่างองค์กรกับผู้ให้บริการรายนั้น
ข้อมูล APM เก็บในประเทศไทยได้ไหม
ได้ ถ้าเลือก Backend โอเพนซอร์ส เราวางระบบบน Cloud Server ใน Data Center มาตรฐาน Tier 3+ ของเราในกรุงเทพฯ หรือขอนแก่น และตั้ง Collector ให้ปิดบังข้อมูลส่วนบุคคลก่อนบันทึก
Apdex คืออะไร
Apdex คือคะแนนความพึงพอใจของผู้ใช้ตั้งแต่ 0 ถึง 1 คำนวณจากเวลาเป้าหมาย T คำขอที่เร็วกว่า T นับเป็นพอใจ ช้ากว่า T ไม่เกิน 4T นับเป็นพอทน สูตรคือ (พอใจ + พอทน ÷ 2) ÷ คำขอทั้งหมด
Distributed Tracing จำเป็นไหม ถ้าแอปอยู่เครื่องเดียว
ยังมีประโยชน์ เพราะ Trace แสดงเวลาที่ใช้ในแต่ละฟังก์ชัน Query และการเรียก API ภายนอกของคำขอนั้น แต่จะคุ้มที่สุดเมื่อแอปแยกเป็นหลายบริการ ซึ่งการหาต้นเหตุจาก Log ของแต่ละเครื่องทำได้ยาก
APM เหมาะกับใคร
เหมาะกับองค์กรที่มีเว็บแอป ระบบ E-commerce, API หรือแอปมือถือที่ผู้ใช้จำนวนมากใช้งานทุกวัน มีหลายบริการต่อกัน หรือเจอปัญหาช้าที่หาสาเหตุจากกราฟเซิร์ฟเวอร์ไม่ได้
ติดตั้ง APM ใช้เวลานานไหม
ขึ้นกับจำนวนบริการ ภาษา และการเข้าถึงระบบ แอปเดียวที่ภาษารองรับการวัดอัตโนมัติเริ่มเห็นข้อมูลได้เร็ว ส่วนระบบหลายบริการต้องวางแผนทีละส่วน ทีมงานแจ้งแผนจริงหลังประเมินระบบ
APM ช่วยเรื่อง Core Web Vitals ได้ไหม
ได้ในส่วน Real User Monitoring ซึ่งเก็บ LCP, INP และ CLS จากผู้ใช้จริง และเมื่อเชื่อมกับ Trace ฝั่งเซิร์ฟเวอร์ จะเห็นว่าหน้าไหนช้าเพราะเซิร์ฟเวอร์ หรือเพราะรูปและสคริปต์ฝั่งเบราว์เซอร์
APM เจอต้นเหตุแล้ว ใครเป็นคนแก้
เลือกได้ ทีม Dev Support ของเราช่วยแก้โค้ดและ Query ต่อได้ หรือเราส่งรายละเอียดพร้อม Trace ตัวอย่างให้ทีมพัฒนาของคุณแก้เอง ส่วนปัญหาฝั่งเซิร์ฟเวอร์ ทีม Managed Services ดูแลตามขอบเขตงาน
ขอคำปรึกษา APM
กรอกข้อมูลสั้น ๆ ทีมงานจะติดต่อกลับภายใน 1 วันทำการ ปรึกษาฟรี ไม่มีข้อผูกมัด