คำตอบสั้น ๆ: ตั้ง Docker Healthcheck ใน Dockerfile และ Compose ให้บริการรอฐานข้อมูลพร้อม อ่านผลด้วย docker inspect และรีสตาร์ต Container ที่ unhealthy อัตโนมัติด้วย autoheal
คู่มือนี้อธิบาย Docker Healthcheck ทีละขั้นตอน พร้อมคำสั่งที่ใช้ได้จริงและปัญหาที่พบบ่อย
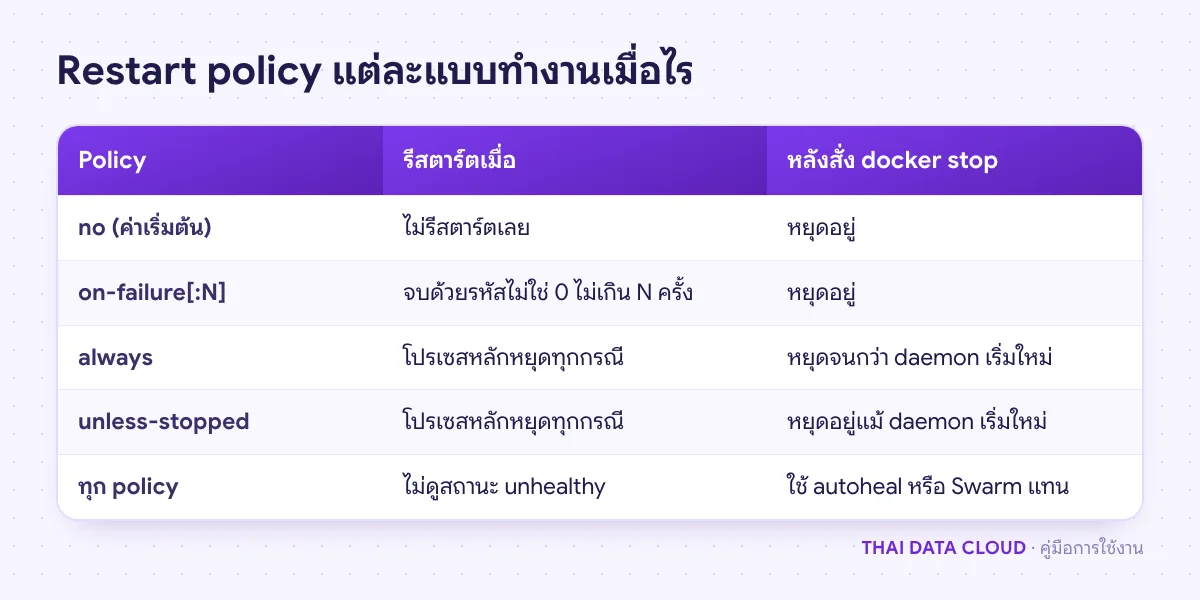
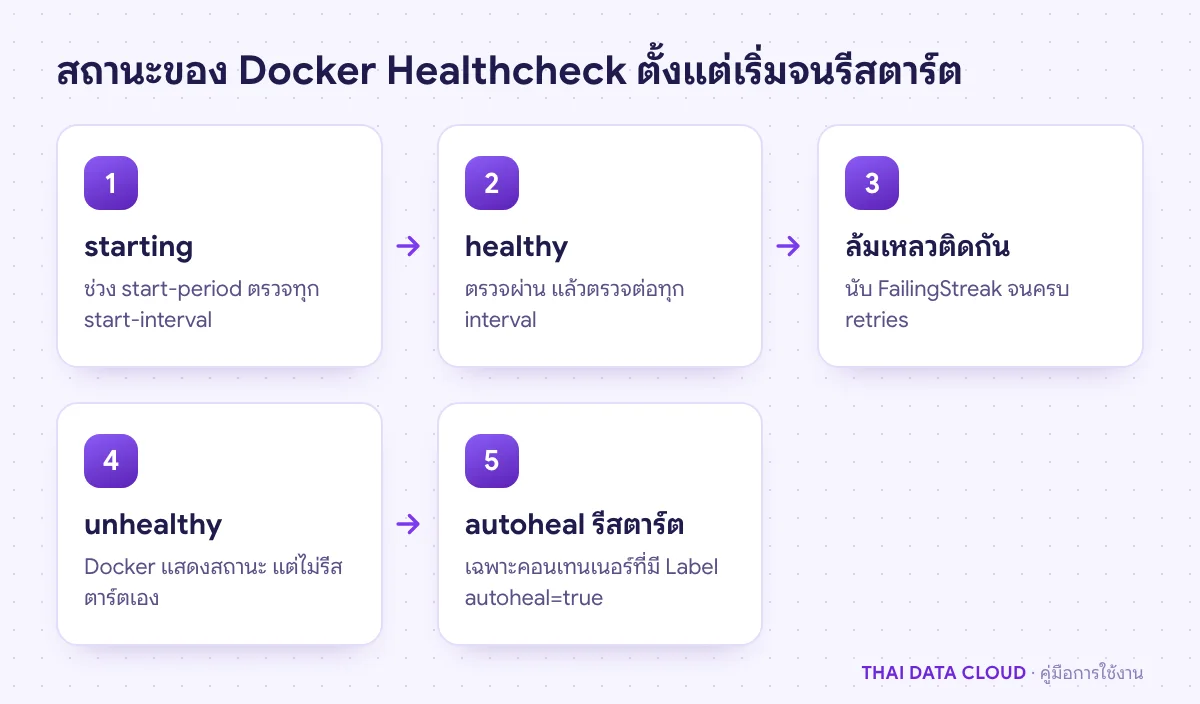
Docker Healthcheck คือคำสั่งตรวจสุขภาพที่ Docker รันซ้ำในคอนเทนเนอร์เป็นระยะ เพื่อบอกว่าแอปข้างในยังตอบงานได้จริงหรือไม่ ผลที่ได้คือสถานะ starting, healthy หรือ unhealthy ที่เห็นใน docker ps สิ่งที่ผู้ดูแลหลายคนเข้าใจผิดคือ Docker แบบเครื่องเดียว (ไม่ใช่ Swarm) ไม่รีสตาร์ตคอนเทนเนอร์ที่ unhealthy ให้เอง Restart policy ทำงานเฉพาะเมื่อโปรเซสหลักจบการทำงาน แอปที่ค้างแต่โปรเซสยังอยู่จึงค้างต่อไปเรื่อย ๆ ถ้าไม่ได้ตั้งอะไรเพิ่ม
คู่มือนี้เหมาะกับผู้ดูแล Linux Server ที่รันเว็บหรือแอปด้วย Docker Compose แล้วเคยเจอแอปค้างตอนกลางคืนจนต้องเข้ามาสั่ง restart เอง เมื่อทำครบ คุณจะมี endpoint ตรวจสุขภาพที่เหมาะสม ตั้ง Docker Healthcheck ได้ทั้งใน Dockerfile และ Compose ให้บริการรอฐานข้อมูลพร้อมก่อนเริ่ม อ่านผลตรวจเป็น ตั้ง Restart policy ให้ถูก และให้คอนเทนเนอร์ที่ unhealthy ถูกรีสตาร์ตอัตโนมัติอย่างปลอดภัย
สิ่งที่ต้องเตรียม
- Docker Engine และ Docker Compose v2 บน Linux Server ถ้ายังไม่มีให้ติดตั้งตาม คู่มือติดตั้ง Docker และ Docker Compose บน Ubuntu ตัวเลือก
start-intervalต้องใช้ Docker Engine 25.0 ขึ้นไป ตรวจด้วยdocker version - แอปที่มีหน้า HTTP หรือคำสั่งที่บอกได้ว่าพร้อมให้บริการ เช่น
/healthzถ้ายังไม่มีให้ขอให้นักพัฒนาเพิ่มตามขั้นตอนที่ 1 - รู้ว่าในอิมเมจมีเครื่องมือใดให้ใช้ อิมเมจแบบ slim หรือ distroless หลายตัวไม่มี
curlหรือแม้แต่ shell - สิทธิ์ใช้คำสั่ง
dockerบนเครื่อง (root หรือผู้ใช้ในกลุ่ม docker)
ขั้นตอนที่ 1: ออกแบบ endpoint ที่ Docker Healthcheck จะเรียก
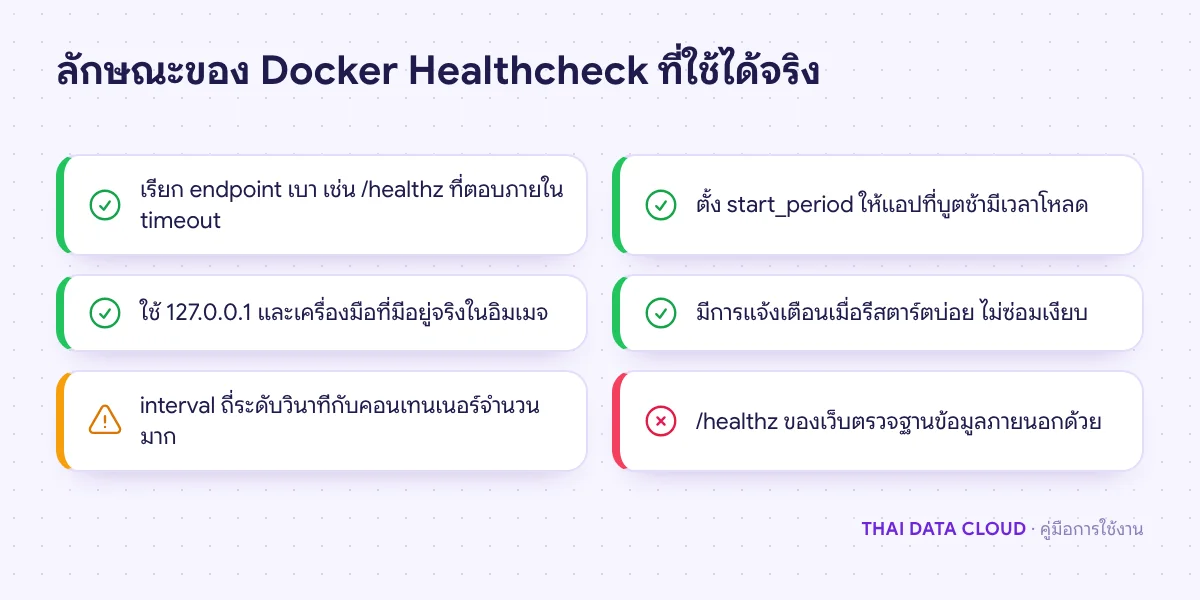
Docker Healthcheck ที่ดีตอบคำถามเดียวว่า “คอนเทนเนอร์นี้รับงานได้ไหม” จึงควรเรียกหน้าที่เบาและเร็ว เช่น GET /healthz ที่ตอบ 200 เมื่อแอปทำงาน และตอบ 500 หรือ 503 เมื่อมีปัญหาภายในตัวเอง เช่น worker ค้างหรือคิวเต็ม
ระวังการผูกการตรวจกับระบบภายนอก ถ้า /healthz ตรวจฐานข้อมูลด้วย เมื่อฐานข้อมูลช้าไม่กี่นาที ทุกคอนเทนเนอร์ของเว็บจะ unhealthy พร้อมกัน และถ้าตั้งรีสตาร์ตอัตโนมัติไว้ จะรีสตาร์ตกันทั้งชุดโดยไม่ช่วยอะไร ให้ตรวจเฉพาะสิ่งที่การรีสตาร์ตคอนเทนเนอร์นั้นแก้ได้ ส่วนสถานะของฐานข้อมูลให้ฐานข้อมูลมี Docker Healthcheck ของตัวเอง
ขั้นตอนที่ 2: เพิ่ม Docker Healthcheck ใน Dockerfile
คำสั่ง HEALTHCHECK ใน Dockerfile ทำให้ทุกคอนเทนเนอร์ที่สร้างจากอิมเมจนี้มี Docker Healthcheck ติดไปด้วย ตัวอย่างแอป Node.js บนอิมเมจ Alpine ซึ่งมี wget ของ BusyBox อยู่แล้ว
FROM node:22-alpine
WORKDIR /app
COPY . .
RUN npm ci --omit=dev
EXPOSE 3000
HEALTHCHECK --interval=30s --timeout=5s --start-period=60s --start-interval=5s --retries=3 \
  CMD wget -qO- http://127.0.0.1:3000/healthz || exit 1
CMD ["node", "server.js"]
ค่าเริ่มต้นตาม เอกสาร Dockerfile reference คือ --interval=30s, --timeout=30s, --start-period=0s, --start-interval=5s และ --retries=3 ความหมายคือ
- interval: รันการตรวจทุกกี่วินาที
- timeout: การตรวจที่ใช้เวลานานกว่านี้นับเป็นล้มเหลว
- start-period: ช่วงเริ่มต้นที่ยังไม่นับความล้มเหลว ให้แอปที่บูตช้ามีเวลาโหลด ระหว่างนี้ Docker ตรวจทุก start-interval
- retries: ล้มเหลวติดกันกี่ครั้งจึงเป็น unhealthy
คำสั่งตรวจต้องจบด้วยรหัส 0 (healthy) หรือ 1 (unhealthy) ห้ามใช้รหัส 2 เพราะ Docker สงวนไว้ จึงต่อท้ายด้วย || exit 1 ถ้ามี HEALTHCHECK หลายบรรทัด จะใช้เฉพาะบรรทัดสุดท้าย และ Docker เก็บข้อความผลลัพธ์ได้เพียง 4096 ไบต์แรก ถ้าอิมเมจต้นทางมี Docker Healthcheck ที่ไม่ต้องการ ใช้ HEALTHCHECK NONE เพื่อปิด
ขั้นตอนที่ 3: ตั้ง Docker Healthcheck ใน Compose และให้บริการรอกัน
ถ้าไม่ได้สร้างอิมเมจเอง ให้ตั้ง Docker Healthcheck ในไฟล์ Compose แทน แล้วใช้ depends_on แบบ condition: service_healthy ให้เว็บเริ่มหลังฐานข้อมูลพร้อมจริง ไม่ใช่แค่คอนเทนเนอร์ถูกสร้าง
# /opt/app/compose.yaml
services:
  db:
    image: postgres:16
    restart: unless-stopped
    environment:
      POSTGRES_DB: app
      POSTGRES_USER: app
      POSTGRES_PASSWORD_FILE: /run/secrets/db_password
    secrets:
      - db_password
    volumes:
      - db-data:/var/lib/postgresql/data
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U app -d app"]
      interval: 10s
      timeout: 5s
      retries: 5
      start_period: 30s

  web:
    image: registry.example.com/shop-web:1.8.2
    restart: unless-stopped
    depends_on:
      db:
        condition: service_healthy
    ports:
      - "127.0.0.1:3000:3000"
    healthcheck:
      test: ["CMD-SHELL", "wget -qO- http://127.0.0.1:3000/healthz || exit 1"]
      interval: 30s
      timeout: 5s
      retries: 3
      start_period: 60s
    labels:
      autoheal: "true"

secrets:
  db_password:
    file: ./db_password.txt

volumes:
  db-data:
cd /opt/app
docker compose up -d --wait
docker compose ps--wait ทำให้คำสั่งรอจนทุกบริการ running หรือ healthy ก่อนกลับมาที่ prompt เหมาะกับสคริปต์ Deploy ที่ต้องรู้ว่าระบบขึ้นสำเร็จ รายละเอียดฟิลด์ทั้งหมดอยู่ใน เอกสาร Compose services: healthcheck
ข้อควรระวังกับฐานข้อมูลอื่น: redis-cli ping ใช้ตรวจ Redis ได้ ส่วน MySQL การใช้ mysqladmin ping จะได้รหัส 0 แม้รหัสผ่านผิด เพราะคำสั่งนี้ตรวจเพียงว่าเซิร์ฟเวอร์ทำงาน ถ้าต้องการตรวจลึกกว่านั้นให้ใช้คำสั่ง SQL จริง และถ้าใช้ตัวแปรของคอนเทนเนอร์ในคำสั่งตรวจ ให้เขียน $$ แทน $ เพื่อไม่ให้ Compose แทนค่าเองตอนอ่านไฟล์
ขั้นตอนที่ 4: อ่านผลของ Docker Healthcheck
docker ps --format 'table {{.Names}}\t{{.Status}}'
docker inspect --format '{{json .State.Health}}' app-web-1 | jq
docker events --filter event=health_status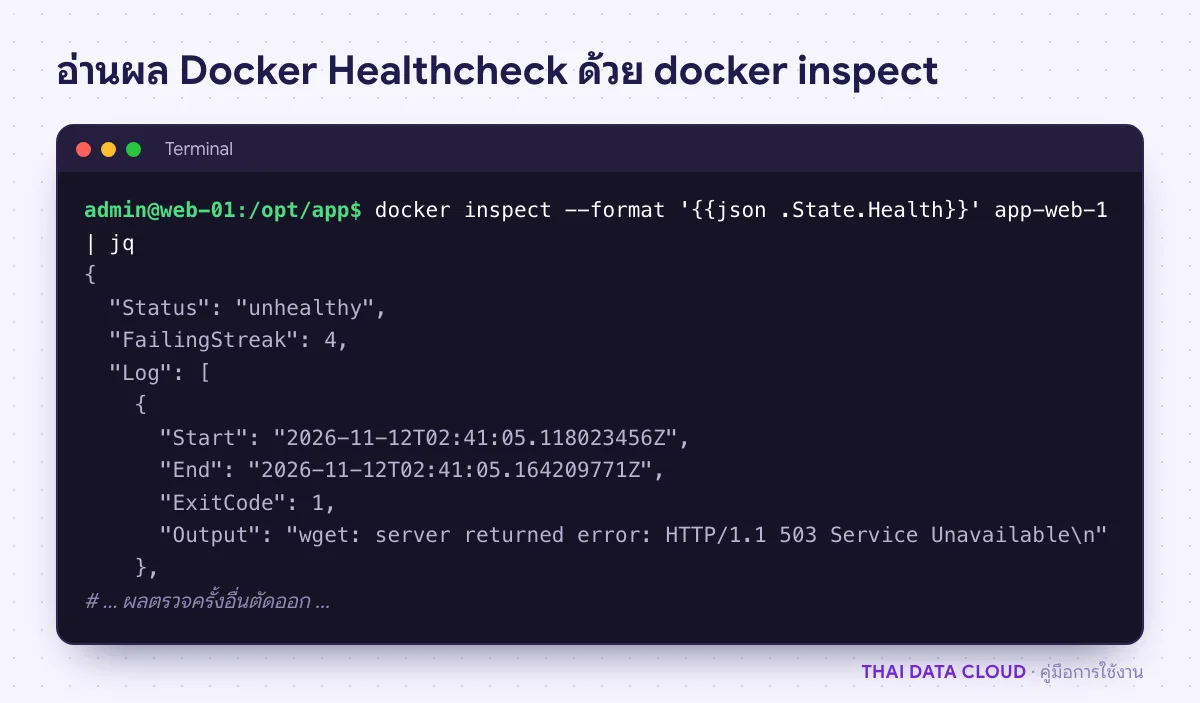
docker inspect แสดงสถานะของ Docker Healthcheck จำนวนครั้งที่ล้มเหลวติดกัน (FailingStreak) และผลตรวจล่าสุดไม่กี่ครั้งพร้อมข้อความที่คำสั่งตรวจพิมพ์ออกมา ใช้หาสาเหตุได้ทันทีว่าแอปตอบช้าหรือตอบ Error ส่วน docker events แสดงทุกครั้งที่สถานะเปลี่ยน เหมาะเปิดดูระหว่างทดสอบ ถ้าต้องการดู Log ของแอปช่วงเดียวกันใช้ docker logs --since 10m app-web-1 และตั้งขนาด Log ไม่ให้ดิสก์เต็มตาม คู่มือจำกัดขนาด Log ของ Docker