คำตอบสั้น ๆ: ตั้ง RTO และ RPO ของแต่ละระบบร่วมกับเจ้าของธุรกิจ เลือกวิธีสำรองและกู้คืนให้ทำได้ตามเป้า วัดเวลากู้จริง เขียน Runbook และทดสอบแผนกู้ระบบตามรอบ
คู่มือนี้อธิบาย RTO ทีละขั้นตอน พร้อมคำสั่งที่ใช้ได้จริงและปัญหาที่พบบ่อย
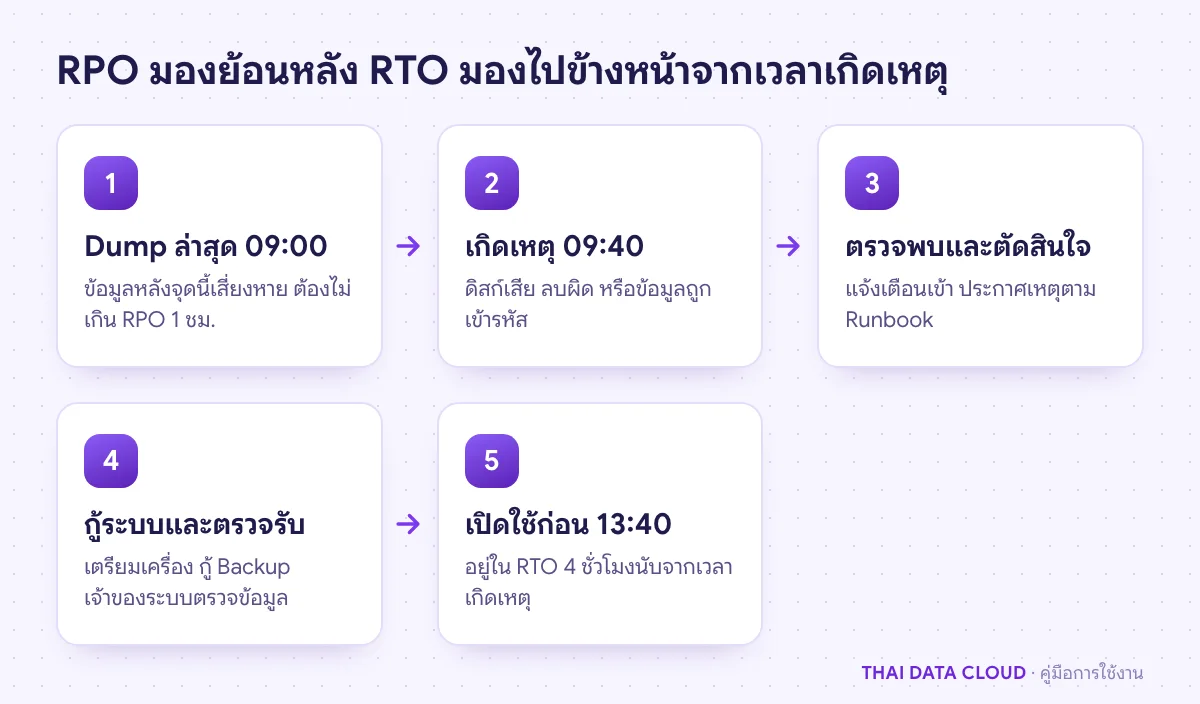
RTO (Recovery Time Objective) คือเวลานานที่สุดที่ระบบหนึ่งหยุดได้ตั้งแต่เกิดเหตุจนกลับมาให้บริการ ส่วน RPO (Recovery Point Objective) คือช่วงข้อมูลย้อนหลังที่ยอมเสียได้ นับจากจุดสำรองล่าสุดถึงเวลาที่เกิดเหตุ ถ้าตั้ง RTO 4 ชั่วโมงและ RPO 1 ชั่วโมง แปลว่าระบบต้องกลับมาภายใน 4 ชั่วโมง และข้อมูลที่หายต้องไม่เกิน 1 ชั่วโมงสุดท้าย สองตัวเลขนี้คือสิ่งที่ฝ่ายไอทีและฝ่ายธุรกิจต้องตกลงร่วมกันก่อนเกิดเหตุ ไม่ใช่ตอนเซิร์ฟเวอร์ล่มแล้ว
คู่มือนี้เหมาะกับผู้ดูแลระบบและผู้จัดการที่ต้องเขียนแผนกู้ระบบ (Disaster Recovery Plan) ให้เซิร์ฟเวอร์ขององค์กร เมื่อทำครบ คุณจะมีตาราง RTO และ RPO ของทุกระบบที่เจ้าของระบบลงชื่อรับรู้ วิธีสำรองข้อมูลที่ทำได้ตามเป้า ตัวเลขเวลากู้คืนที่วัดจริง Runbook ที่คนอื่นหยิบไปทำตามได้ และตารางทดสอบที่ทำให้ตัวเลขทั้งหมดยังเป็นจริงอยู่
สิ่งที่ต้องเตรียม
- รายชื่อระบบและเซิร์ฟเวอร์ทั้งหมด พร้อมเจ้าของระบบฝั่งธุรกิจที่มีอำนาจตัดสินใจ เช่น ผู้จัดการฝ่ายขายสำหรับระบบร้านค้าออนไลน์
- วิธีสำรองข้อมูลที่ใช้อยู่ตอนนี้ของแต่ละระบบ ความถี่ ที่เก็บ และขนาดข้อมูล ถ้ายังไม่เป็นระบบ ให้ทำตาม คู่มือวาง Backup Plan ตามกฎ 3-2-1 ควบคู่กัน
- ประวัติเหตุขัดข้องที่ผ่านมา เช่น เคยล่มกี่ครั้ง นานเท่าไร และเสียหายอะไร ช่วยให้คุยเรื่องตัวเลขได้จากเหตุจริง
- เซิร์ฟเวอร์ทดสอบหนึ่งเครื่องสำหรับวัดเวลากู้คืนในขั้นตอนที่ 4
- เวลาประชุมกับเจ้าของระบบอย่างน้อยหนึ่งชั่วโมงต่อกลุ่มระบบ
ขั้นตอนที่ 1: ประเมินผลกระทบเมื่อแต่ละระบบหยุด
ก่อนตั้ง RTO ให้ถามเจ้าของระบบทีละระบบว่า ถ้าระบบนี้หยุด 1 ชั่วโมง 4 ชั่วโมง 1 วัน และ 3 วัน จะเกิดอะไรขึ้น คำตอบที่ต้องการคือผลกระทบที่จับต้องได้ เช่น รับออเดอร์ไม่ได้ ออกใบกำกับภาษีไม่ทัน พนักงานคลังสินค้าทำงานไม่ได้ หรือผิดสัญญาให้บริการกับลูกค้า
แนวทางของ NIST SP 800-34 (Contingency Planning Guide for Federal Information Systems) เรียกขั้นนี้ว่า Business Impact Analysis และกำหนดคำว่า Maximum Tolerable Downtime (MTD) คือเวลาหยุดสูงสุดที่ธุรกิจทนได้ก่อนเสียหายร้ายแรง RTO ของระบบต้องสั้นกว่า MTD เสมอ เพราะหลังระบบกลับมาแล้วยังต้องมีเวลาตรวจข้อมูลและตามงานที่ค้าง
ในเวลาเดียวกันให้ถามเรื่องข้อมูลด้วยว่า ถ้าข้อมูลย้อนกลับไปเมื่อคืน ต้องคีย์ใหม่กี่รายการ มีข้อมูลที่หาย้อนหลังไม่ได้หรือไม่ เช่น ออเดอร์ที่ลูกค้าชำระเงินแล้ว คำตอบนี้คือจุดเริ่มของ RPO
ขั้นตอนที่ 2: ตั้งค่า RTO และ RPO ของแต่ละระบบ
จัดระบบเป็นกลุ่มตามผลกระทบ แล้วตั้ง RTO และ RPO ต่อกลุ่ม ตัวเลขในตารางด้านล่างเป็นตัวอย่างของบริษัทขนาดกลาง แต่ละองค์กรต้องตั้งเองจากผลในขั้นตอนที่ 1
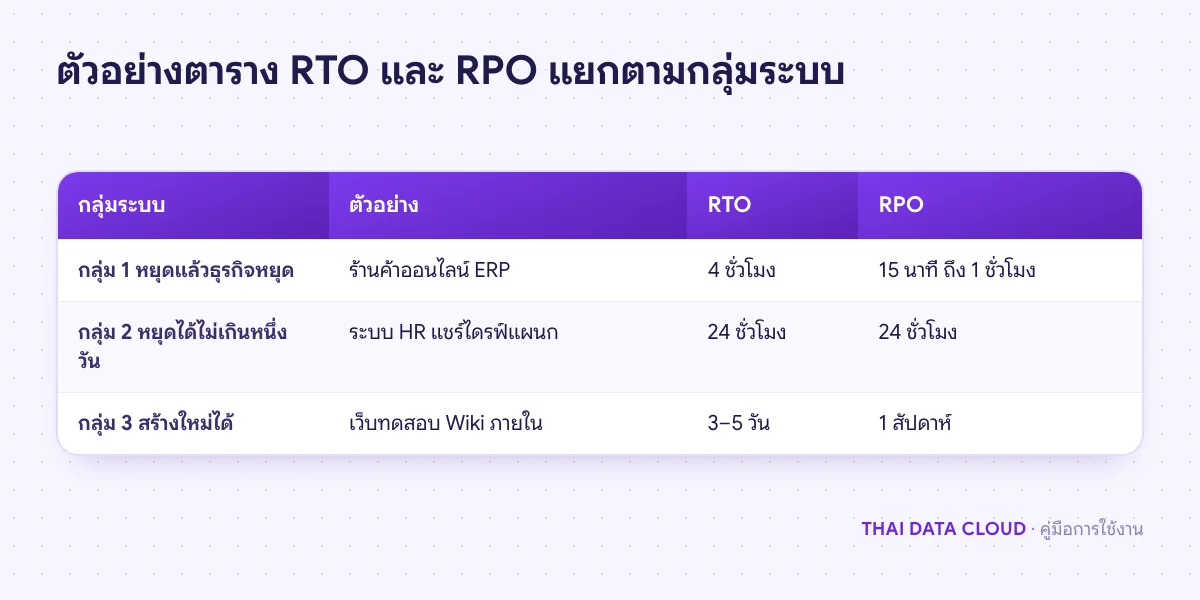
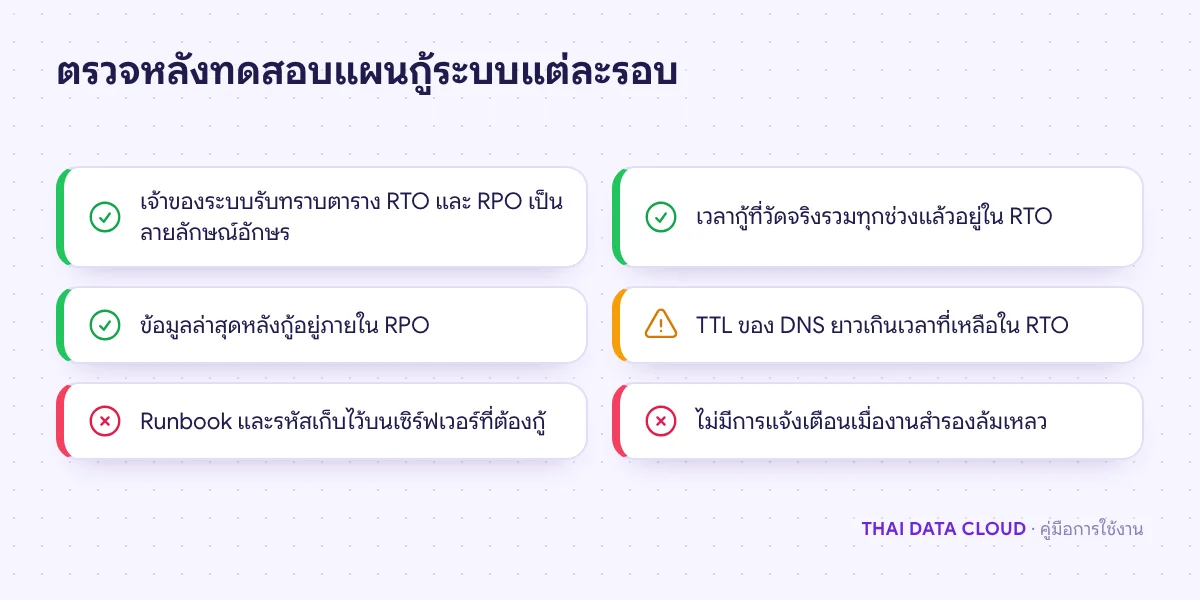
บันทึกตารางนี้ในเอกสารที่เจ้าของระบบรับทราบ ระบุด้วยว่าตัวเลขใช้กับเหตุแบบใด เช่น เซิร์ฟเวอร์เสียหนึ่งเครื่อง ข้อมูลถูกลบหรือถูกเข้ารหัส หรือศูนย์ข้อมูลทั้งศูนย์ใช้ไม่ได้ เพราะ RTO ของสองกรณีแรกมักสั้นกว่ากรณีหลังมาก ถ้าเจ้าของระบบขอ RTO 15 นาทีแต่ไม่ยอมรับค่าใช้จ่ายของเครื่องสำรองที่เปิดรอ ให้บันทึกตัวเลขที่ทำได้จริงพร้อมเหตุผล ดีกว่าเขียนตัวเลขที่ไม่มีใครทำได้
ขั้นตอนที่ 3: เลือกวิธีสำรองและกู้คืนให้ทำได้ตามเป้า
RPO กำหนดความถี่ของการสำรอง
- RPO 24 ชั่วโมง: สำรองวันละครั้งตอนกลางคืนเพียงพอ
- RPO 1 ชั่วโมง: Dump ฐานข้อมูลทุกชั่วโมง หรือสำรองรายวันคู่กับเก็บ Binary Log แล้วกู้ย้อนถึงเวลาที่ต้องการตาม คู่มือกู้ MySQL ย้อนเวลาด้วย Binary Log
- RPO ไม่กี่นาที: ต้องมีสำเนาที่ซิงก์ต่อเนื่อง เช่น MySQL Replication ไปยังเครื่องอีกศูนย์ข้อมูล ร่วมกับ Backup ปกติ เพราะ Replica ไม่กันการลบผิด
RTO กำหนดรูปแบบการกู้คืน
- RTO หลายวัน: สร้างเครื่องใหม่แล้วกู้จาก Backup นอกสถานที่
- RTO ไม่กี่ชั่วโมง: เตรียม Image หรือสคริปต์ติดตั้งเครื่องไว้ล่วงหน้า สำรองไว้ใกล้ที่จะกู้ และซ้อมจนรู้เวลาจริง
- RTO ต่ำกว่าหนึ่งชั่วโมง: ต้องมีเครื่องสำรองที่เปิดรอ (DR site) มีข้อมูลล่าสุด และมีขั้นตอนสลับที่ทดสอบแล้ว
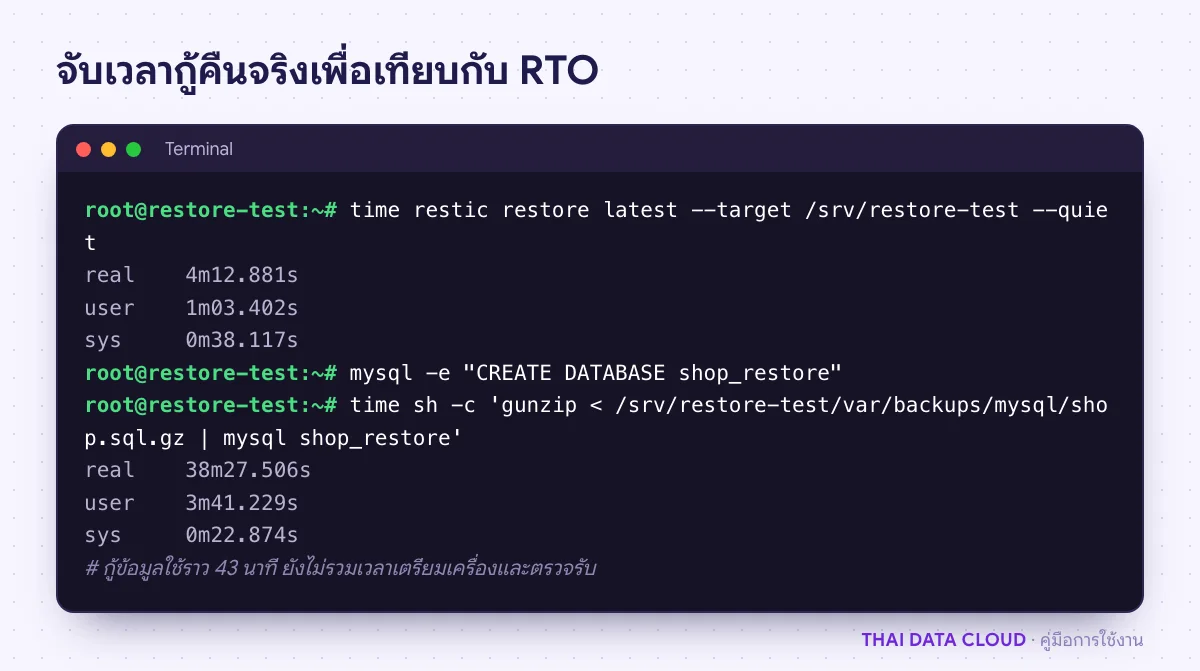
RTO คือผลรวมของหลายช่วง ไม่ใช่แค่เวลาคัดลอกข้อมูล ให้แยกเวลาออกเป็น ตรวจพบเหตุ ตัดสินใจกู้ เตรียมเครื่อง กู้ข้อมูล ตรวจความถูกต้อง และสลับผู้ใช้มาที่ระบบใหม่ ช่วงสุดท้ายรวมเวลาที่ DNS ใช้กระจายค่าใหม่ ถ้า TTL ของระเบียนเป็น 3600 วินาที ผู้ใช้บางส่วนอาจยังวิ่งไป IP เดิมได้นานถึงหนึ่งชั่วโมง วิธีวางค่า TTL ดูใน คู่มือ TTL และการย้าย DNS